RNA-Seq解析で、データの問題を発見できるか?
RNA-Seqデータ解析では、PCA、ヒートマップ、DEG解析、エンリッチメント解析など、多様な結果を簡単に得られるツールが増えています。しかし、得られた結果を信頼してよいかどうかを判断するには、解析に使用したデータそのものを調べる必要があります。
以前の記事「データの可視化による問題の発見」では、多発性硬化症(MS)患者とHealthy Control(HC)のRNA-Seqデータ(GSE173789)を解析し、一部のサンプルにGene Countsの分布の歪みがあることを確認しました。この歪みによって、正規化後の発現値が相対的に高く見える遺伝子群が生じ、DEG解析の結果にも影響していることを明らかにしました。 さらに、HCサンプルの中にも、異なる発現パターンを示す集団が存在していました。
こうしたデータの構造や、それが解析結果に与える影響は、一般的なRNA-Seq解析ツールでも発見・検証できるのでしょうか。このシリーズでは、同じデータを使い、異なる解析ツールで問題を発見し、その原因や解析結果への影響を検証できるかを調べています。目的は解析ツールの優劣を決めることではありません。研究者がデータの問題に気づき、元のデータに立ち返って検証しやすい解析環境とはどのようなものかを考えることです。
まずは、以前のケーススタディ、または下記のショート解説1の動画で、このデータセットの特徴を確認してから、この先を読み進めることをお勧めします。
今回は、Webベースの解析プラットフォーム、Galaxyを使ってRNA-Seqデータを解析します。
このデータをFASTQから解析し直し、各工程でどのようなQC情報が示され、その情報を発現プロファイルや比較結果と結びつけて判断することがどの程度容易なのかを、実際の操作を通じて検討しました。解析手順については、Galaxy Training Network(GTN)のRNA-Seq reads to countsおよびRNA-seq counts to genesを参考にしています。
Galaxyでは、まず「解析を最後まで通すこと」に注意が向きやすい
Galaxyを実際に使って強く感じたのは、複数のツールを順番につないで解析を組み立てていく作業の多さです。FASTQをFastQCへ渡し、その結果をMultiQCでまとめ、paired-endデータをHISAT2へ渡し、得られたBAMをfeatureCountsへ渡し、さらにGene Countsをlimmaで解析できる形式へまとめていきます。
実際には、それぞれのステップで細かな問題が起こります。今回も、解析に入る前のFASTQ取得から問題がありました。Galaxy上でSRA accessionからFASTQを取得しようとしたとき、fasterq-dumpではエラーが発生し、利用者側からは原因を簡単に特定できませんでした。データ側の問題なのか、NCBI側なのか、Galaxy側なのか、ネットワークや一時的なサービス障害なのかを切り分けるのは容易ではありませんでした。この問題は、fastq-dumpに切り替えることで回避できました。
その後も、FastQCの結果をMultiQCへ渡すためにcollectionの形を整えるなど、ツール間でデータを受け渡すための細かな作業がありました。HISAT2の実行では、2サンプルがsignal 9で終了する問題を解決できず、この2サンプルを以降の解析から除外しました。これはサンプルの品質を評価した結果ではなく、処理を完了できなかったことによる除外です。
こうした問題は、解析を先へ進めるためには一つずつ解決しなければなりません。そのため今回の作業でも、注意が「なぜこのジョブが失敗したのか」「どの形式なら次のツールへ渡せるのか」「どうすれば最後まで処理を通せるのか」という方向へ向きました。エラーを解決して次のステップへ進み、最終的にDEG解析まで到達すると、それだけで一連の解析を無事に終えたような感覚も生まれます。
今回はAIの助けも利用したため、設定やエラーへの対応を進めやすくなりました。それでも、解析を最後まで正常に実行することに注意が向きがちで、得られた結果をどう解釈すべきかという難しさは残りました。
FastQCとMultiQCには多くの情報があるが、比較結果への影響までは分からない
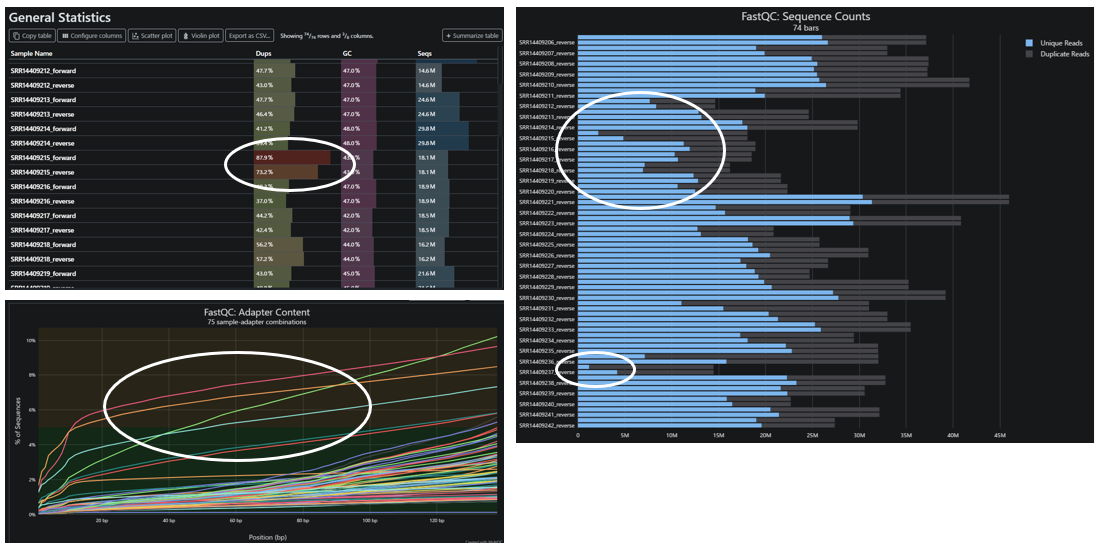
最初にすべてのFASTQについてFastQCを実行し、MultiQCで結果をまとめました。リード数、塩基配列の品質、重複率(Duplication)、アダプター配列の含有状況(Adapter Content)など、多くのQC情報を一覧で確認できます。今回のデータでも、サンプル間でリード数にはかなり大きな違いがあり、一部のサンプルではDuplicationやAdapter Contentにも他のサンプルとは異なる傾向が見られました。
今回は、以前の解析から、QC指標の違いと発現プロファイルの特徴に対応が見られるという予備知識があったため、注意して確認しました。しかし、何の事前知識もない状態で同じレポートを見た場合、その違いが最終的な群間比較にどの程度影響するかを読み取るのは容易ではありません。RNA-SeqではDuplicationが高いこと自体が必ずしも品質の問題を意味するわけではなく、リード数にもばらつきがあります。
経験豊富な解析者であれば、QC情報から追加の確認が必要なサンプルに気づき、その後の工程でも追跡するかもしれません。しかし、どの情報をどのように追跡すればよいかが分からなければ、サンプル間に違いがあることを確認するだけで、次の工程へ進んでしまうことも考えられます。
サンプル名がIDだけだと、レポートを直感的に理解しにくい
今回の解析でもう一つ感じたのは、サンプル名の付け方が結果やレポートの理解に大きく影響するということです。Galaxy内でSRA accessionからFASTQを取得すると、今回の場合はSRR accessionがそのままデータセット名として使われました。そのため、MultiQCやfeatureCounts、後のMDS(多次元尺度構成法)プロットなどを見ても、SRR14409217やSRR14409222といった番号だけでは、それがMultiple sclerosis(MS、多発性硬化症)なのかHealthy Control(HC、健常対照)なのかを直感的に判断できません。
もちろん対応表を見れば確認できます。しかし、解析工程をまたいで複数のレポートを比較するたびに対応表へ戻る必要があり、それだけでも判断の負担は大きくなります。特に今回のように、リード数、Gene Countsの分布、遺伝子への割り当て率(assignment率)、MDS上の位置、疾患区分の関係を確認したい場合には、サンプルIDから実験条件を読み取れないことが理解を難しくします。
可能であれば、解析の初期段階で、元のIDを残しつつ主要な実験条件をサンプルラベルに含めておく方がよいでしょう。例えば、
SRR14409217_MS_sample01
のようにしておけば、各レポートでサンプルと実験条件を対応づけやすくなります。
ただし、今回のようにGalaxyに組み込まれたfastq-dumpなどを使って多数のSRA Runをまとめて取得した場合、生成されたデータセット名を後から一つずつ変更するのは煩雑です。解析前にサンプルIDと実験条件の対応を整理し、早い段階で分かりやすいサンプルラベルを設定しておくことが重要だと感じました。
featureCountsのレポートにも、サンプル間の違いが現れる
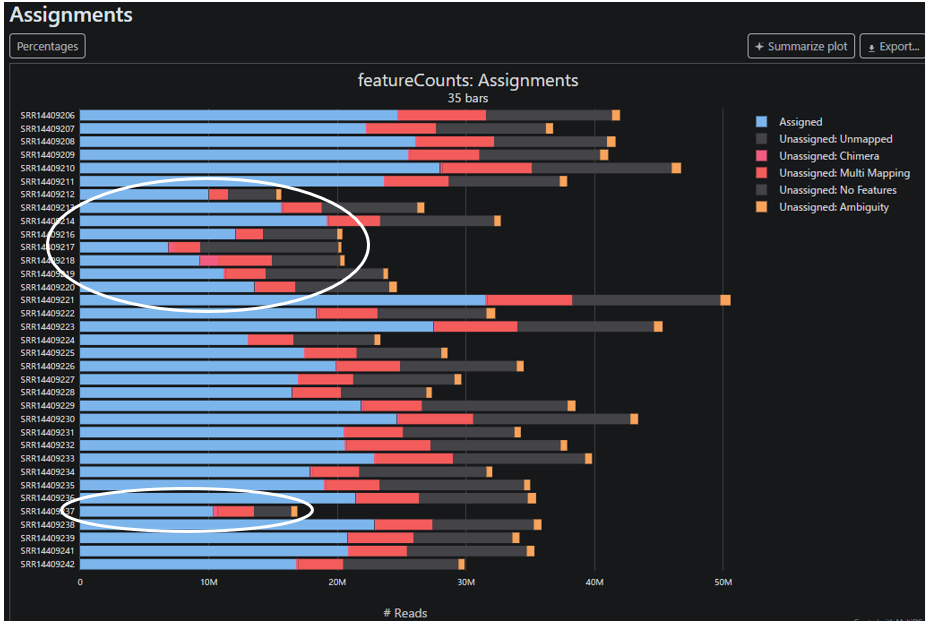
featureCountsを実行した後、MultiQCでassignment率を確認しました。多くのサンプルではおよそ55~64%でしたが、一部ではかなり低い値になっていました。ただし、この指標と、Gene Countsの分布や発現プロファイルとの対応は、別途確認する必要があります。assignment率が低いという情報だけでは、そのサンプルが群間比較にどの程度影響するかまでは分かりません。
ここでも、レポートには確認すべき情報が現れています。しかし、その情報を後の発現データと結びつけなければ、assignment率に違いがあったという確認だけで、次の統計解析へ進むことになります。
サンプル構造とQC指標の関係を整理しないまま、limma-voomまで進めた
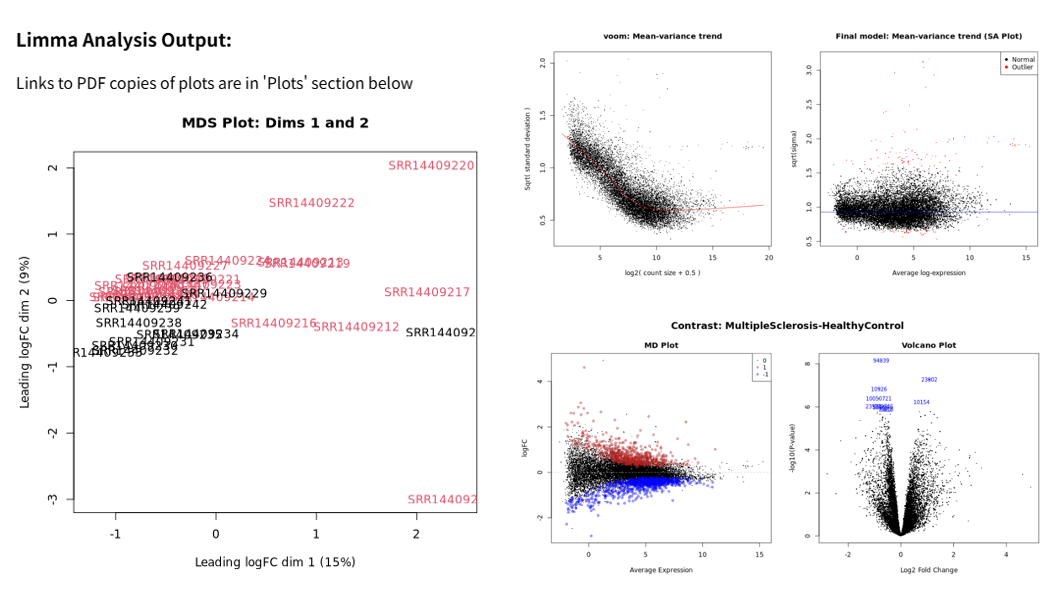
featureCountsで得られたGene Countsを結合し、limma-voomによる発現変動解析を行いました。比較したのはMSとHCです。低カウントの遺伝子についてはCPMに基づくフィルタリングを行い、TMMによる正規化と、voomによる平均と分散の関係のモデル化を行いました。
limmaのレポートにはMDS plot、mean-variance trend、model fit、MD plot、Volcano plotなどが表示されます。処理は完了し、mean-variance trendにも目立った違和感はなく、Volcano plotには多数のDEG候補が表示されました。多重検定補正後のP値(adjusted p-value)などを基準にDEGを抽出すれば、そのままGO解析やパスウェイ解析へ進むこともできます。
MDSプロットでは、MSとHCが一定程度分離しているように見えます。疾患区分を表すDiseaseStateだけで色分けして見ると、二群の発現プロファイルに違いがあることに注意が向きます。しかし、その群間差がどのサンプル群の特徴に強く依存しているのか、先に見たQC指標の違いとどう対応しているのかは、この時点では整理できていませんでした。
標準的な解析を最後まで実行し、診断プロットを確認し、さらにDEG候補まで得られると、それだけで結果の確認を十分に行えたように感じます。今回の操作では、QC情報と発現プロファイルの関係を十分に理解しないままでも、DEG解析まで進められることを実感しました。
解析結果を元のGene Countsと合わせて見ると、情報の関係が見えてくる
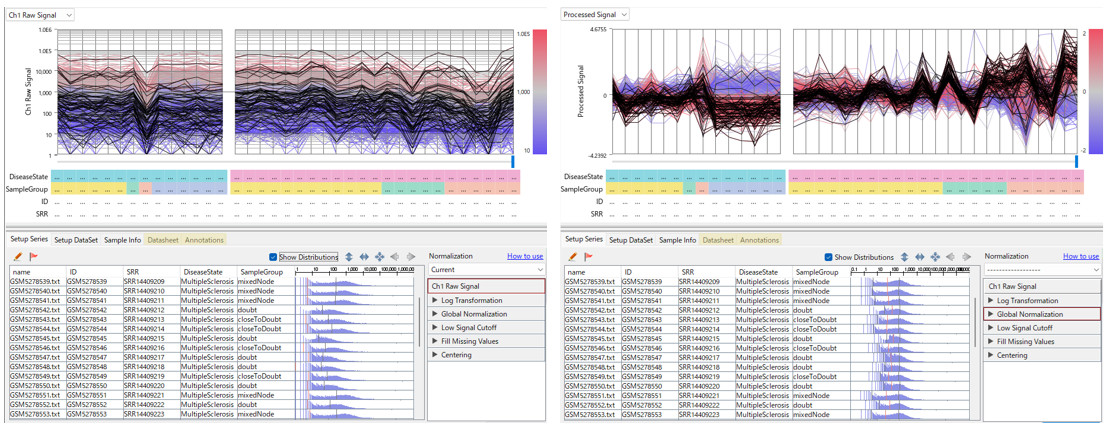
そこで、featureCountsで得られたGene Countsと解析結果をSubio Platformでまとめて可視化しました。Figure 4では、同じ遺伝子とサンプルについて、左に正規化前のGene Counts、右に正規化後の値を示しています。上段のライングラフで個々の遺伝子の発現パターンを、下段のヒストグラムで各サンプル内の値の分布を確認できます。
ここで使うSampleGroupは、以前のケーススタディで確認した特徴に基づくサンプル群のラベルです。doubtは分布形に歪みが見られたサンプル、closeToDoubtは階層型クラスタリングでそれらと同じクラスターにまとまったサンプルを示します。
下段のヒストグラムを見ると、これらのサンプルでは、正規化前のGene Countsの分布が他のサンプルより左側に寄っています。正規化によって値が引き上げられると、ヒストグラムの右側の山は他のサンプルと同程度の位置に移動します。一方、その移動に伴って、ヒストグラムの左側には値が表示されない空白の領域が生じています。 山の位置が揃っても、低値域を含めた分布形状には違いが残っています。
このように低値域が乏しくなる分布の特徴は、以前のケーススタディで用いた公開CPMデータでも確認しています。FASTQからGene Countsを作り直した今回の解析でも、対応するサンプルで、正規化後に同様の分布の特徴が確認できました。
この分布の変化を、上段のライングラフで個々の遺伝子について確認できます。黒線は、MSでHCより発現が高いと判定された遺伝子の一部です。これらの遺伝子にも、該当するサンプルでは元のGene Countsが他のサンプルより低いものが多く見られますが、正規化後には相対的に高い値を示すものが見られます。ヒストグラムで確認した値の引き上げと低値域の空白が、個々の遺伝子では、これらのサンプルで発現が高く見えることに対応しています。
こうして正規化前後の値を見比べると、「MSで発現が高い」というDEG解析の結果に、どのサンプル群のどのような測定値が寄与しているのかを具体的に検討できます。FASTQのリード数、featureCountsのassignment率、元のGene Countsの分布、正規化前後の変化、そしてMDSやDEGの結果を同じサンプルについて照らし合わせることが、DEG解析の結果を正しく理解するために重要なのです。
GalaxyのQCレポートでも、一部のサンプルでGene Countsの分布が低カウント側に寄っていることは確認できました。しかし、その図だけから、正規化後にはこれらのサンプルで一部の遺伝子が相対的に高い値を示し、MSで発現が高いと判定されることにつながるとまで読み取ることは容易ではありません。
limma-voomが評価することと、解析者が判断すること
limma-voomでは、与えられたカウントデータに対してライブラリサイズや平均と分散の関係を考慮し、指定された実験デザインに基づいて群間差を評価します。一方、その群間差を疾患に関連する変化としてどこまで解釈できるかは、サンプルの背景や実験条件、観察された発現プロファイルも踏まえて検討する必要があります。
FastQC、HISAT2、featureCountsなどの工程を経て解析可能な発現行列が得られたことと、その行列から得られる群間差を研究目的に沿って解釈できることは、別の確認事項です。統計解析が完了し、有意な差が得られたことだけでは、その差が何を反映しているかまでは確定しません。
各ツールのレポートを確認するだけでは、情報のつながりを捉えにくい
FastQCはリードの品質などを確認する情報を出力し、featureCountsはリードなどを遺伝子へ割り当てて集計し、その内訳を報告します。limmaは与えられた発現行列と実験デザインに基づいて統計解析を行い、診断プロットや解析結果を出力します。それぞれの工程で、解析に必要な情報が得られています。
GTNの教材にも、MDSや分布の可視化によるQC、追加の実験要因を考慮した解析などが案内されています。確認のための機能や手順は用意されています。しかし今回の操作では、FASTQでリード数が少なかったサンプルが、featureCountsでどの程度のカウント値を持ち、MDSでどこに位置し、どの疾患区分に属しているのかを、レポート間で対応づけながら確認する必要がありました。
個々のレポートでは、解析方針への影響を判断しにくかった違いが、同じサンプルについて見比べることで、一つの傾向として見えてきました。QC指標を個別に確認することに加えて、それらを発現データや実験条件と結びつけて確認できることが重要です。サンプル名がSRR番号だけでは理解しにくかったのも、このためです。
それでも、解析者は判断しなければならない
情報をまとめて見ても、サンプルを解析に含めるべきか、除外すべきかを一意に決められるとは限りません。リード数、Duplication、assignment率、MDS上の位置などの意味は、実験条件や解析目的によっても異なります。これらの特徴だけから、サンプルの取り扱いを決められるわけではありません。
例えば、技術的な要因と疾患区分が重なっていれば、観察された差にそれぞれがどの程度寄与しているかを、発現データだけで区別することは難しくなります。その判断には、実験ノートやサンプルの背景情報も必要になります。一方で、原因が確定できなくても、特定のサンプル群を含めるかどうかによって比較結果がどの程度変わるかは検討できます。
解析者には、こうした検討を踏まえて、どの比較から何を述べられるのか、結果をどこまで信頼して解釈するのかを判断する役割が残ります。だからこそ、リード数、assignment率、Gene Countsの分布、正規化前後の変化、MDSやDEG、さらにサンプルIDと実験条件を、まとめて確認するための手段が必要です。
パイプラインを動かすことと、解析することは別
以前、RNA-Seq解析で、ヒートマップとDEG解析に異なる値を使ってもよいのか?では、異なるツールで使われている値の違いが十分に意識されないまま、それぞれの結果が同じ現象を示したものとして解釈される問題を取り上げました。使用する値や変換が異なれば、可視化が示す関係と統計解析が検定する内容を、区別して理解する必要があります。
今回Galaxyを使って感じたのは、工程ごとに確認した情報を結びつける難しさです。FastQC、featureCounts、limmaなどのレポートには重要な情報が含まれています。しかし、一つ一つを確認するだけでは、そこで見られたサンプル間の違いが、後の発現プロファイルや群間比較とどう関係するかを捉えにくいことがありました。
二つの記事に共通する課題は、複数のツールから得られた情報を結びつけて解釈することです。どの値を使い、どのサンプルについて、何を比較した結果なのか。その対応を保ちながら解析全体を見渡す必要があります。
この課題は、BioconductorやPythonなどで複数のツールやパッケージを組み合わせて解析する場合にも生じます。決められたパイプラインを実行し、各ツールの設定やエラーに対処することに加えて、工程間の情報を結びつけて検討することが求められます。
信頼性の高いツールで構成されたパイプラインを最後まで動かせたからといって、得られた結果の解釈まで保証されるわけではありません。複数の工程を通して得られた情報を、解析全体として統合して解釈すること。それこそが解析者の役割です。
シリーズ:RNA-Seq解析ツールでデータの問題を発見できるか?
同じRNA-Seqデータ(GSE173789)を使い、 データに潜む問題を発見し、その原因や解析結果への影響を検証できるかを 調べた記事シリーズです。
- データの可視化による問題の発見 ― 発現分布の歪みと、その解析結果への影響を検証
- Galaxyを使ったRNA-Seq解析 ― 標準的なワークフローによる解析と検証
- RaNA-Seqを使ってみた ― FASTQからの自動解析と結果の検証
- RNAseqChefを使ってみた ― 多様な解析機能と探索的検証
- iDEPを使ってみた ― 豊富なQCグラフからデータの問題を発見できるか?
- バイオインフォマティクス教育の第3の視点 ― AI時代に必要な、解析結果を批判的に評価する力