RNA-Seq解析では、発現変動遺伝子(DEG)を抽出し、その遺伝子リストを使ってGO解析やパスウェイ解析(Pathway解析)などのエンリッチメント解析(Enrichment解析)を行うことが一般的です。しかし、その入力となる遺伝子リストに目的の遺伝子が含まれているか、しっかり考えていますか?
そもそも、どのような遺伝子リストをEnrichment解析に入力するのか。
Enrichment解析の代表的な手法の一つに、過剰代表解析(Over-Representation Analysis:ORA)があります。これは、入力された遺伝子リストにどのような機能的な偏りがあるかを調べる方法です。しかし、その遺伝子リストが研究目的に適しているかどうかを、ORAが判断してくれるわけではありません。今回は、複数のTreatmentを比較する簡単な例を使って、遺伝子リストの作り方を考えます。さらに、DEGを抽出する際の統計的な閾値が、その遺伝子リストとEnrichment解析の結果にどのような影響を与えるのかを考えてみましょう。
1. 前提として、よくある実験デザインを想定します
Control (Ct)、Treatment 1 (T1)、Treatment 2 (T2)という3条件を仮定します。さらに、研究目的として注目しているのはT1で、T2はT1と似た効果を持ちますが、T1に特異的な特徴を知りたいと仮定します。
まず、3つの比較を行います。
| 比較 | 発現上昇と判定 | 発現下降と判定 | いずれにも判定されない |
|---|---|---|---|
| Ct vs T1 | UP1 | DOWN1 | Non-DEG1 |
| Ct vs T2 | UP2 | DOWN2 | Non-DEG2 |
| T1 vs T2 | UP3 | DOWN3 | Non-DEG3 |
UP3は、T1の方がT2より発現量が高い遺伝子、DOWN3はその逆と定義します。
最初は話を単純にするため、統計的な検定は考えず、発現量が2倍以上ならUP、1/2以下ならDOWN、それ以外は変化なしとします。そして、UP1を興味の対象と仮定して、DOWN1はここでは考えないことにします。
例えば、次の4つの遺伝子を考えます。
| 遺伝子 | Ct | T1 | T2 |
|---|---|---|---|
| Gene A | 100 | 200 | 100 |
| Gene B | 100 | 200 | 190 |
| Gene C | 100 | 400 | 200 |
| Gene D | 100 | 200 | 50 |
T1では、すべての遺伝子がCtと比べて2倍以上上昇していますが、T2との関係は異なります。
- Gene A:T1では上昇するが、T2では変化しない。解析目的に合う、「欲しい遺伝子」の代表と言えます。
- Gene B:両Treatmentでほぼ同じように上昇する。ただし、DEG判定の閾値すれすれでDEGリストから漏れる遺伝子です。解析目的にとっては、「欲しくない遺伝子」の代表と言えます。そして、T1とT2の効果が似ていることから、Gene Bの発現パターンはかなり多くの遺伝子が示すものと考えられます。
- Gene C:T1で4倍上昇し、T2でも2倍上昇する。T2でも十分に高い発現を示すので、T2での高さの解釈によって「欲しい遺伝子」になったり「欲しくない遺伝子」になったりします。
- Gene D:T1では上昇するが、T2では下降する。これもGene C同様、T2での低さの解釈によって「欲しい遺伝子」になったり「欲しくない遺伝子」になったりします。
この4つの遺伝子を使って、Enrichment解析に投入する遺伝子リストの作り方を考えてみましょう。
2. UP1 NOT UP2では、何が分かるのか
T1に特徴的な発現上昇遺伝子を探そうとすると、最初に思いつきやすいのは次の集合です。
UP1 NOT UP2
T1でUPと判定され、T2ではUPと判定されなかった遺伝子を抽出します。
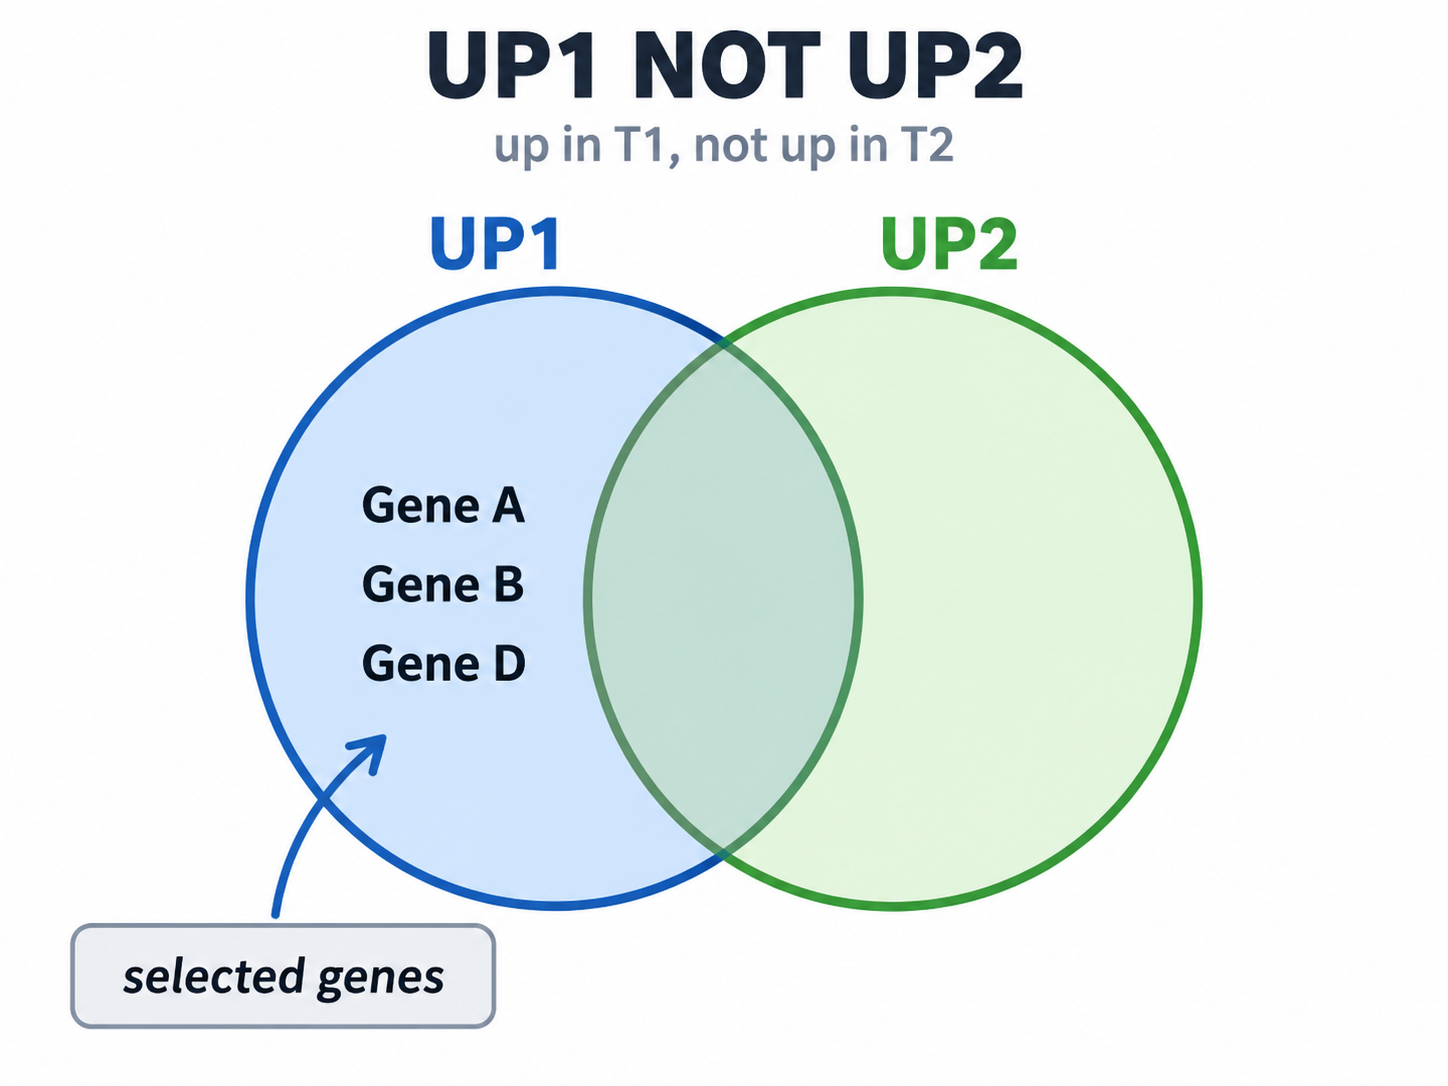
先ほどの例では、Gene A、B、Dが含まれます。ここに、Gene Bが含まれることに注目してください。UP1 NOT UP2に含まれるからといって、T1とT2の作用が大きく異なるとは限りません。そして、Gene Bのような遺伝子が、リスト「UP1 NOT UP2」には多く含まれると考えられます。この遺伝子リストをEnrichment解析すると、両Treatmentに共通する作用に関係したGOやPathwayが、Treatment 1に特徴的な機能であるかのように見えてしまうかもしれません。
3. UP1 ∩ UP3なら、Treatment間の違いを考慮できる
では、次の集合はどうでしょうか。
UP1 ∩ UP3
UP1はT1がCtより上昇した遺伝子、UP3はT1がT2より高い遺伝子です。この2つの条件を組み合わせれば、Treatment 1で上昇し、さらにTreatment 2よりも高い遺伝子を抽出できます。
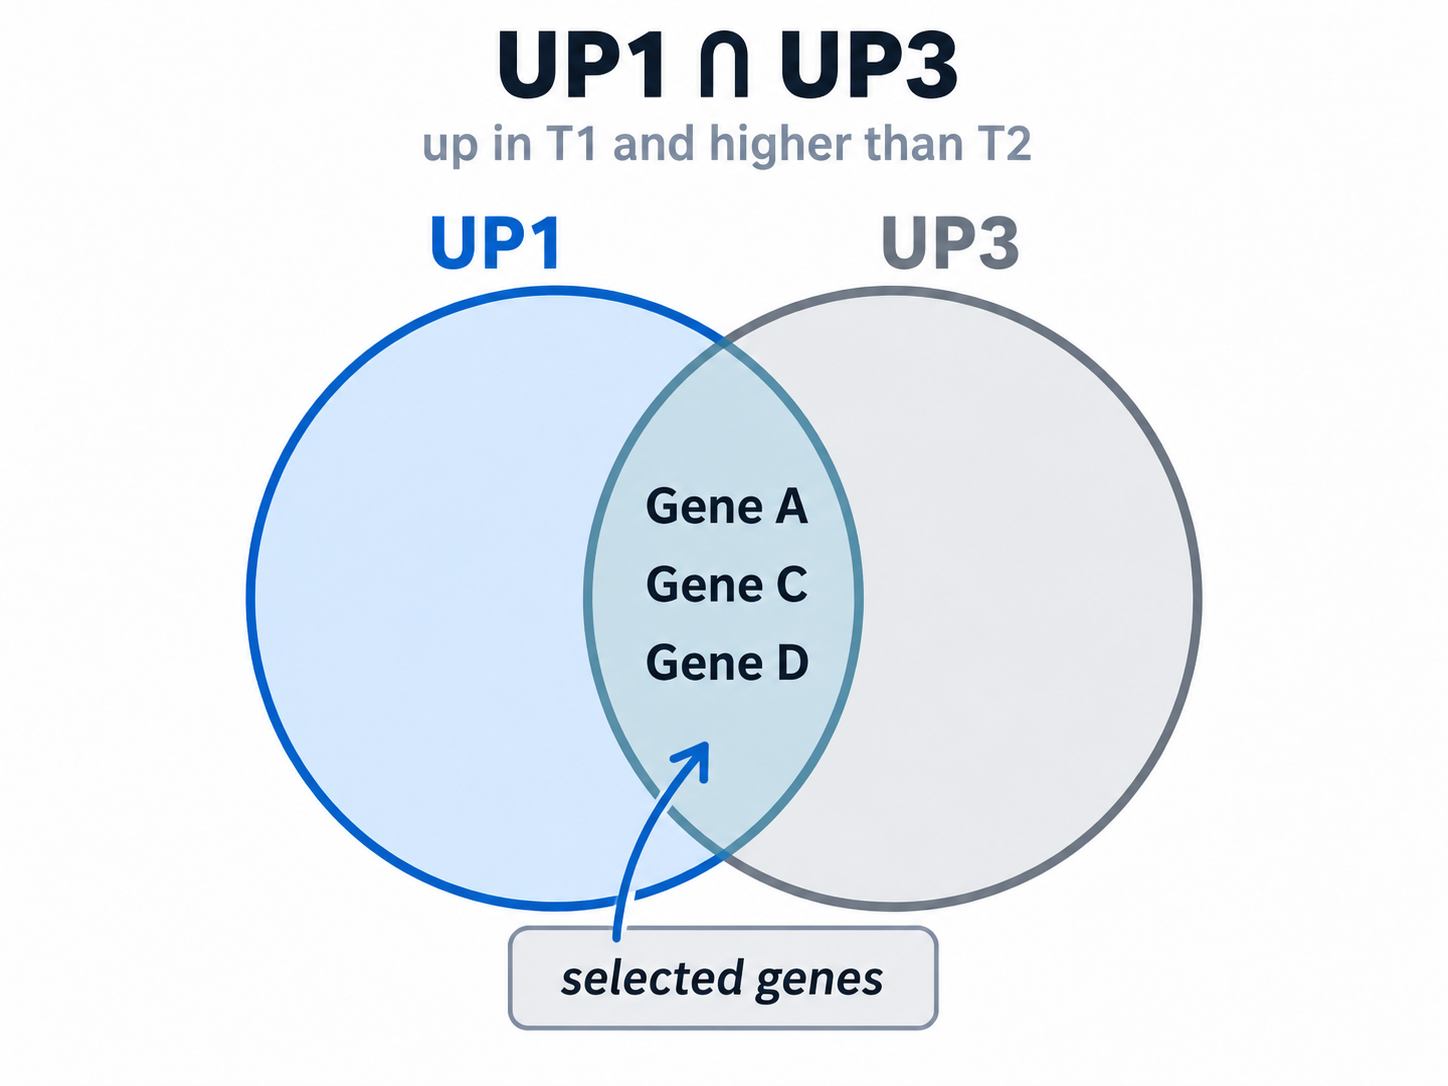
先ほどの4遺伝子では、Gene A、C、Dが含まれます。このリストには、Gene Bが含まれません。UP1 NOT UP2よりも、Treatment間の違いを直接考慮できる点で、今回の研究目的に近い方法です。
しかし、Gene Cについては検討の余地があります。T2である程度高いことがT1とT2のよく似た効果に資するのであれば、Gene Cを含まないリストが欲しいと思うかもしれません。
4. (UP1 ∩ UP3) NOT UP2なら、さらに目的を絞り込める
T1で上昇し、T2よりも高いだけでなく、T2ではUPと判定されない遺伝子を探したいなら、次の集合が考えられます。
(UP1 ∩ UP3) NOT UP2
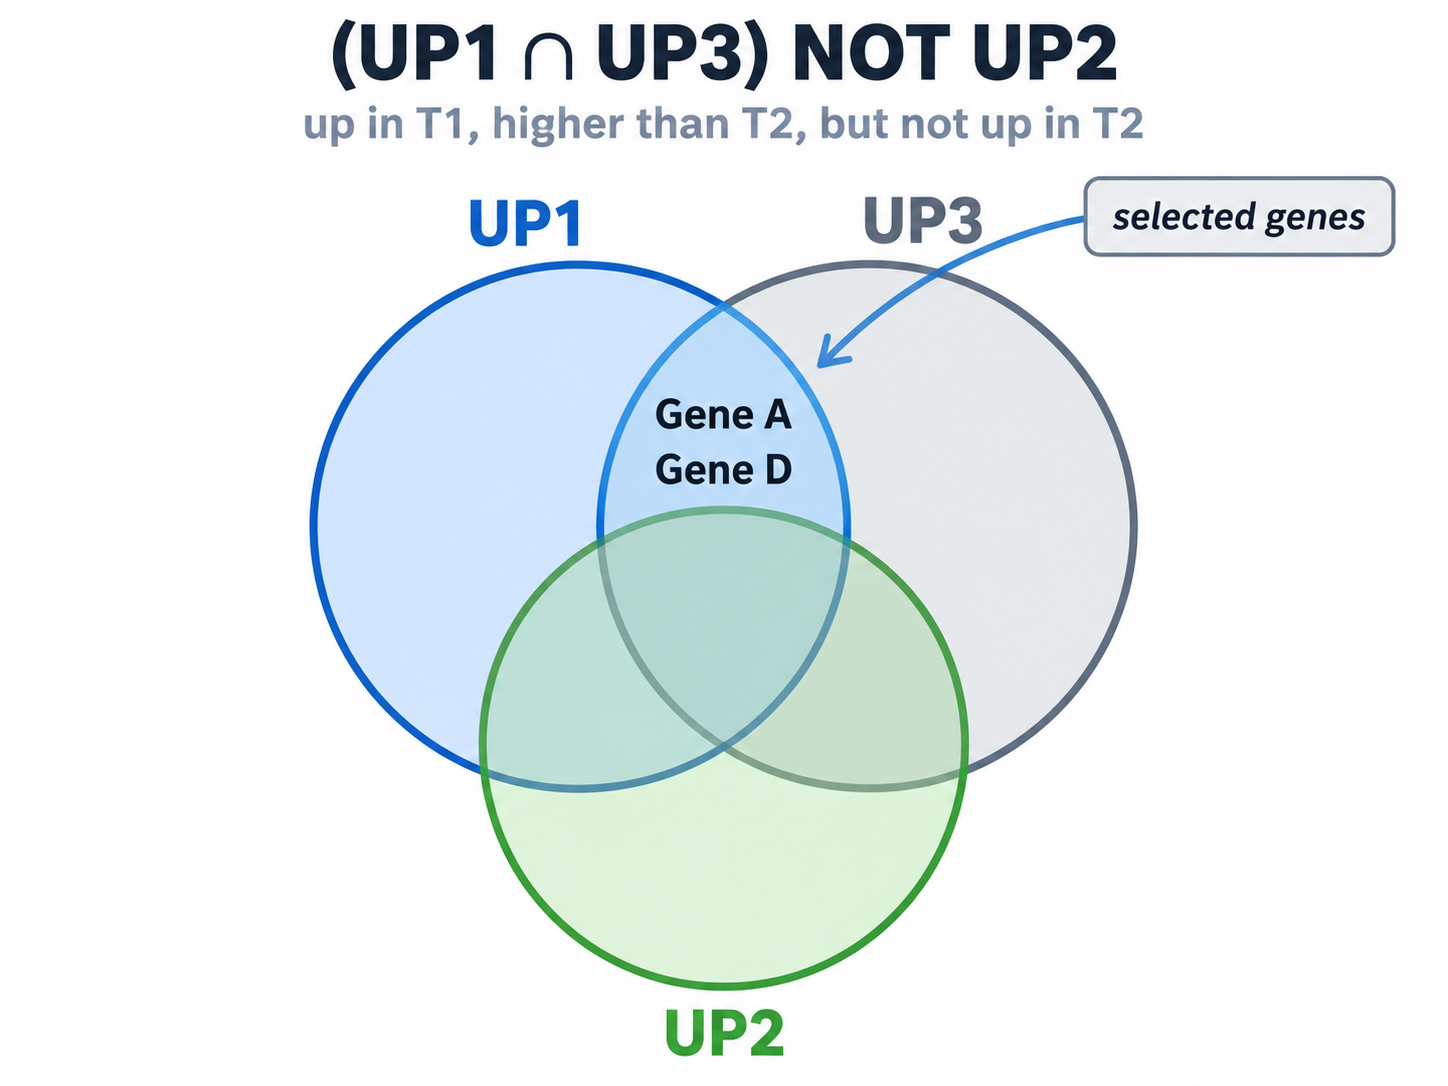
この方法なら、先ほどの4遺伝子では、Gene AとGene Dが残ります。
Gene DはTreatment 2では逆方向に変化しているため、Gene Aとは異なる意味で興味深い遺伝子です。もしTreatment 2で下降する遺伝子も除外し、Treatment 2では大きな変化を示さない遺伝子だけを探したいのであれば、
UP1 ∩ UP3 ∩ Non-DEG2
という集合も考えられます。
このように、Enrichment解析のインプットとなるリストの作り方しだいで、結果として現れる生物学的機能タームが変わることが分かります。
5. DEGの検定を厳しくすると、何が起こるのか
ここまでは、説明を単純にするためFold ChangeだけでUPやDOWNを判定してきました。しかし、実際のRNA-Seq解析では統計的な検定によってDEGを抽出します。さらに、査読者からFDRなどを使って偽陽性を厳しく抑えるように求められることも一般的です。
ここでは、その厳しさが、後に続くEnrichment解析にとってどう影響するかを考えてみましょう。前提として、T1とT2の作用が基本的によく似ています。この場合、Gene Bのように、両Treatmentで似た発現変化を示す遺伝子が多いと想定できます。
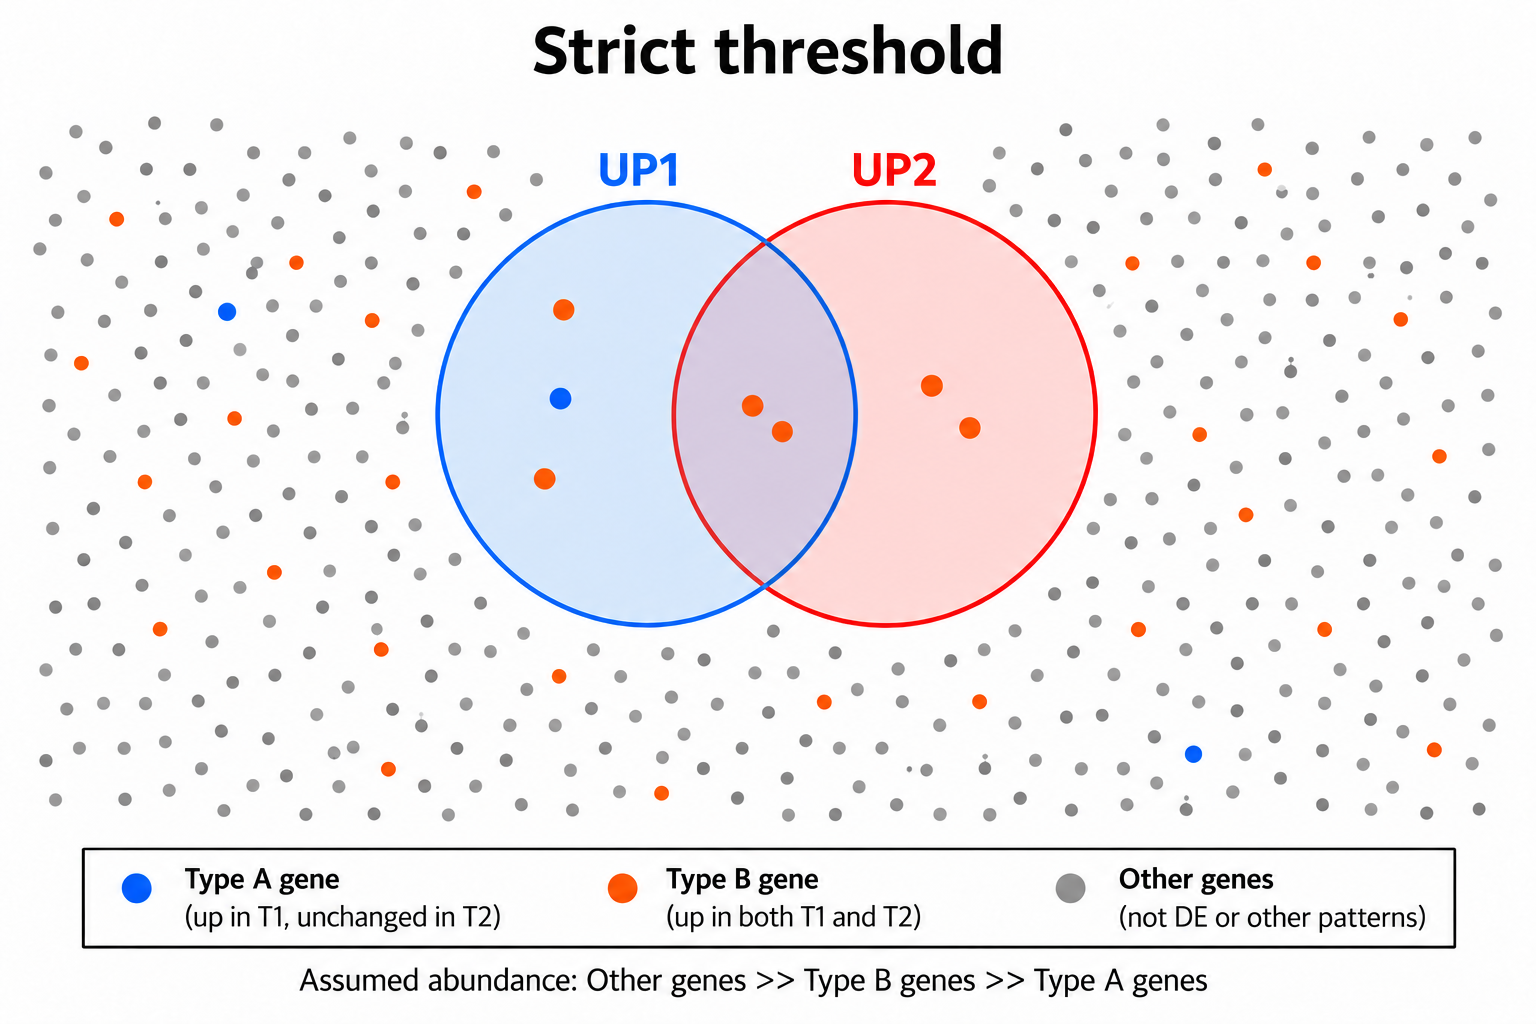
ここで統計的な閾値を厳しくすると、UP1にもUP2にも含まれない遺伝子が増えます。本来注目したいGene Aタイプであっても、その多くがUP1から脱落することになります(偽陰性の増加)。同様に、両Treatmentで似た発現変化を示すGene Bタイプも、多くがUP1とUP2の両方から脱落します。一方で、有意判定されたごく一部のGene Bタイプの遺伝子は、UP1、UP2、あるいは両者の共通部分のいずれにも入りえます。
その結果、UP1 NOT UP2には、T1に特徴的な遺伝子が少数しか残らない一方で、両Treatmentで似た変化を示す遺伝子も混入することになります。しかも、Gene Bタイプの割合が小さくなるとも限りません。
UP1 ∩ UP3や(UP1 ∩ UP3) NOT UP2のような集合でも同様のことが起こるのですが、複数の条件を同時に満たす必要があるため、厳しい閾値による遺伝子の取りこぼしがさらに大きくなり、Enrichment解析に使用できる遺伝子が大幅に減る、あるいはほとんど残らないことにもなりえます。
つまり、厳しい統計的基準でDEGを抽出したからといって、Enrichment解析のインプットに適した遺伝子リストが得られるとは限らないのです。
6. 閾値を緩めることで、むしろ目的に近づく場合がある
では、検定の閾値を緩めるとどうなるでしょうか。例えば、nominal p値で0.05未満、0.1未満、0.2未満など、かなり緩めの設定にすると考えてみましょう。
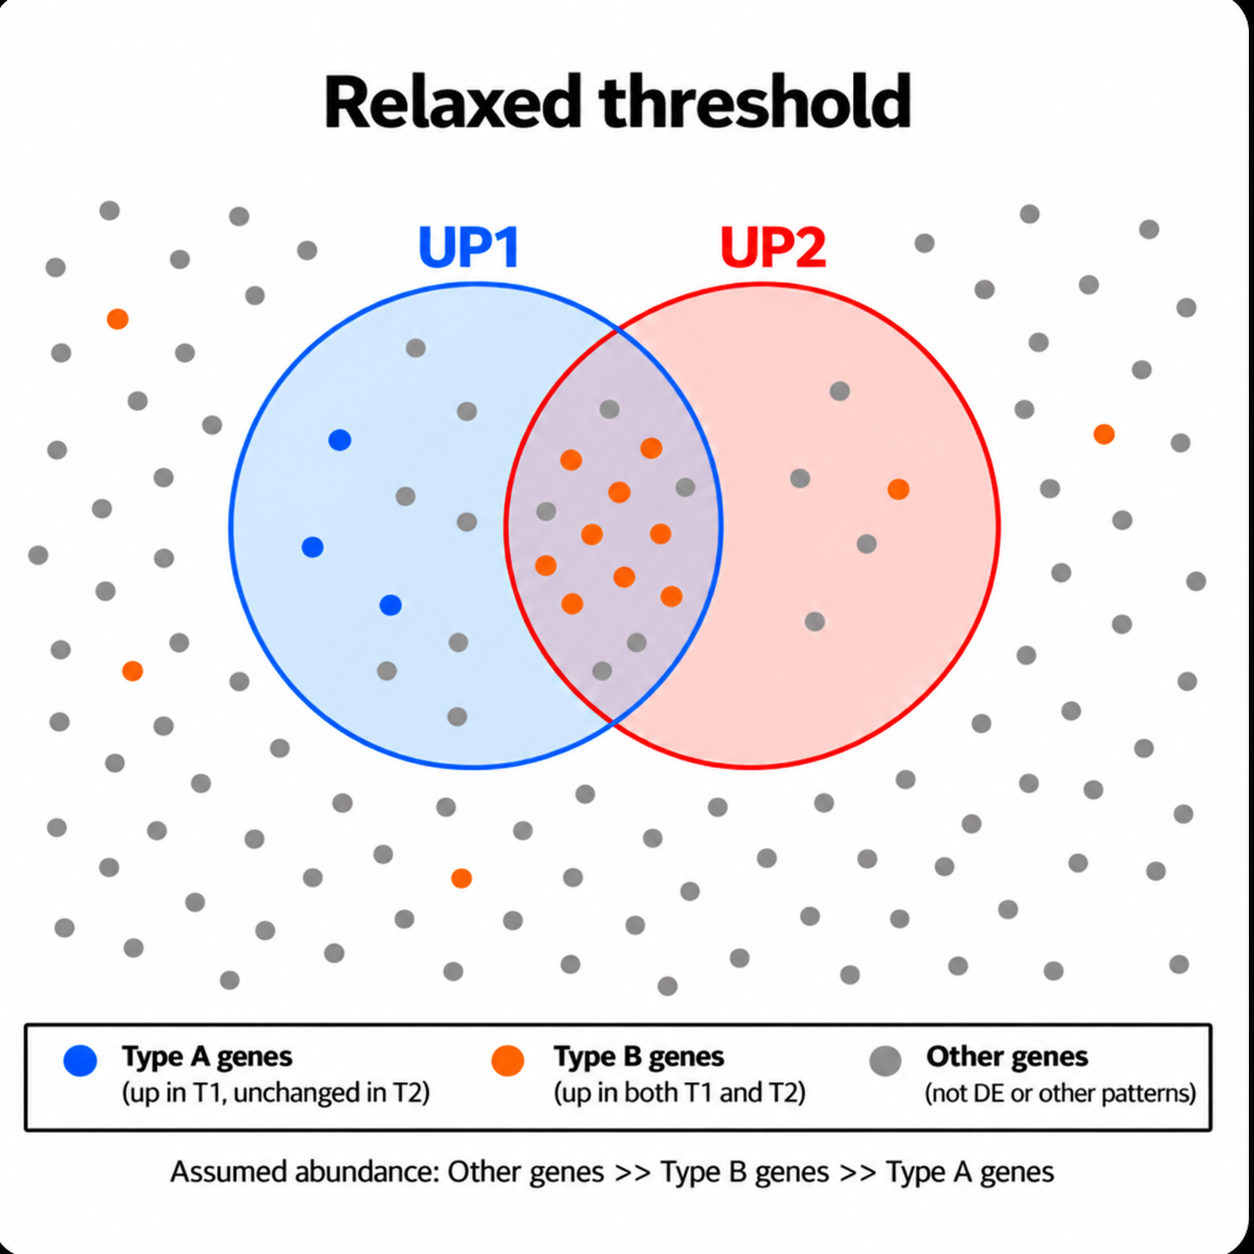
閾値を緩めると、UP1やUP2など単独のリストを考えると偽陽性がより多く含まれるため、遺伝子リストは大きくなります。しかし、個々の遺伝子リストではなく、遺伝子リストを組み合わせるとどうなるでしょうか。ここで興味深いのは、Gene Bタイプの遺伝子です。Gene Bタイプの遺伝子は、閾値を緩めることで、UP1にもUP2にも多く含まれるようになります。その結果、UP1とUP2の共通部分が増え、UP1 NOT UP2に残る遺伝子が、T1に特徴的な発現パターンを持つ遺伝子に近づく可能性があります。
つまり、閾値を緩めることは、遺伝子集合の構成を研究目的に近づける方向に働く場合があると考えられるのです。
一方で、閾値を緩めるとUP3にも遺伝子が入りやすくなります。本当はTreatment間の差が小さい遺伝子までUP3に含まれる可能性があるため、UP1 ∩ UP3だけでは、意図していない遺伝子が混入することがあります。そこで、(UP1 ∩ UP3) NOT UP2という条件が意味を持ちます。UP1とUP3によってTreatment 1の上昇とTreatment間の違いを捉え、さらにUP2を除外することで、Treatment 2でも上昇している遺伝子を取り除くことが狙えます。
このように、遺伝子リスト単独で考える場合に検定の厳しさが与える影響と、遺伝子リストを組み合わせる場合に検定の厳しさが与える影響は、まったく別の物差しで評価する必要があるのです。
7. DEGの偽陽性は、Enrichment解析にどう影響するのか
ここで視点を変えます。閾値を緩めることで偽陽性が増えることが、Enrichment解析にどのような影響があるかを考えてみます。偽陽性が機能に対してランダムに混入するなら、遺伝子レベルの偽陽性が増えてもEnrichment解析結果での偽陽性が増えるとは限りません。むしろ、検定の閾値すれすれのところで有意判定からもれた機能に関与する遺伝子が増えることで、Enrichmentシグナルを強めることが考えられます。一方で、検定の閾値を厳しくすることは、閾値境界すれすれの機能に関与する遺伝子を多く排除することで、Enrichmentシグナルを薄める方向に働きうると考えられます。
つまり、検定の厳しさが遺伝子リストに与える影響と、検定の厳しさがEnrichment解析に与える影響は、まったく異なるとも考えられるのです。
そのため、DEG解析における一つの閾値を正解として固定するのではなく、閾値を変えたときに遺伝子集合の構成やEnrichment結果がどう変わるかを確認することが、生物学的な解釈においてはとても重要なのです。
8. なぜ、この基本的な考え方が重要なのか
ここまで、Enrichment解析に入力する遺伝子リストの作り方と、DEGの検定閾値がその結果に与える影響について考えてきました。
しかし、一般的なRNA-Seq解析ワークフローでは、こうした問題がほとんど意識されていません。
一般的なワークフローでは、
Gene Counts → DEG解析 → Enrichment解析 → 生物学的解釈
という順序で解析が進められます。しかし、ここには見落とされやすい問題があります。それぞれの解析ツールが解こうとしている問題は、必ずしも同じではないのです。 DEG解析では、個々の遺伝子について発現変化を統計的に判定します。偽陽性を抑えるためにFDRを厳しく設定することには、明確な意味があります。問題は、このような目的意識のみで抽出されたDEGリストが、そのままEnrichment解析に渡されがちなことです。
「FDRを厳しくするべきだ」という主張も、「閾値を緩めるべきだ」という主張も、実際のデータや解析目的を確認せずに一律に適用を要求するのであれば、同じ問題を抱えていると言わざるを得ません。重要なのは、どちらの基準が一般的に正しいかではなく、実際の解析で何が起こっているかを調べることです。言い換えると、一方通行に解析を進めるだけではなく、閾値を変えながら何が変わるかを観察することが、生物学的洞察につながるのです。
このような作業は従来なかなか手間がかかるものでしたが、今ではDEGリストやEnrichment解析の結果をAIに渡せば、閾値によって何が変わったのか、どのような生物学的特徴が現れた(消えた)のかを整理してくれます。解析者は、結果の解釈や妥当性の検証に、より多くの時間と集中力を割けるようになりました。
解析は、一通りのツールをつつがなく完了させることではないのです。Enrichment解析は、遺伝子リストを入力してGOやPathwayの一覧を得るだけの作業ではありません。どのような遺伝子リストを作り、そのリストから何が見え、何が見えなかったのか。そこまで考えることが、Enrichment解析の基本なのだと思います。
Master Analysis, Not the Tool.
Subio Platformは、AI・R・Pythonなどで得られた解析結果を可視化し、その妥当性をご自身で確かめるための環境を提供します。解析結果を共有し、議論につなげることもできます。
Visualize and validate your results.
Subio Platform 製品紹介 | RNA-Seqデータ解析サービス