遺伝子発現データに対するZ-score変換には、大きく分けて二つの使い方があります。
- 各遺伝子のサンプル間における相対的な変化を示すために、遺伝子ごとにZ-score化するgene-wise Z-score
- 各サンプルの遺伝子発現値の分布を揃えるために、サンプルごとにZ-score化するsample-wise Z-score normalization
gene-wise Z-scoreは、RNA-Seqのヒートマップなどで広く使われています。この場合の注意点については、RNA-Seqのヒートマップで、Z-scoreを安易に使うべきでない理由で詳しく説明しています。一方、この記事で扱うのは、sample-wise Z-score normalizationです。
sample-wise Z-score normalizationは、マイクロアレイ時代に、異なるサンプルから得られた遺伝子発現データを共通の尺度へ揃える方法として使われてきました。しかし、2色法マイクロアレイと1色法マイクロアレイでは、Z-score化の対象も、その意味も異なります。2色法では二つの試料間のシグナル比または対数比を標準化するのに対し、1色法では一つの試料から得られた全遺伝子のシグナル値を標準化します。さらに、測定できる遺伝子数が増え、非発現遺伝子や低発現遺伝子が大量に含まれるようになると、全遺伝子の値を一つの分布とみなし、単一の平均と標準偏差で揃えるという考え方自体が成り立ちにくくなりました。
この記事では、sample-wise Z-score normalizationが2色法マイクロアレイでどのような意味を持っていたのか、1色法への移行によって何が変わったのか、そして網羅的な遺伝子発現データに適用するとどのような問題が生じるのかを整理します。
2色法マイクロアレイでは、二つの試料の比が測定されていた
初期のスポット型2色法マイクロアレイでは、二つの試料をCy5とCy3で標識し、同じスポット上で測定しました。各遺伝子について得られる値は、Cy5とCy3のシグナル比、またはその対数比です。
一方、初期のスポット型マイクロアレイには、多くの技術的な問題がありました。
- スポットごとのDNA量の違い
- スポット形状や位置の不均一性
- 局所的な背景シグナル
- Cy5とCy3の色素特性の違い
- 標識効率の違い
- スキャン条件の違い
- シグナル強度に依存した偏り
このような技術的なばらつきが大きかったため、何らかの正規化を行わなければ、異なるマイクロアレイから得られた結果を比較することが困難でした。そのような状況では、各マイクロアレイの対数比の中心や広がりを揃える処理には実用的な意味があり、sample-wise Z-score normalizationも、そのような発想から生まれた方法の一つに数えられます。
技術的な分散を揃えると、生物学的な分散も見えなくなる
ただし、sample-wise Z-score normalizationによって揃えられるのは、技術的な分散だけではありません。たとえば、細胞分化をタイムコースで測定する実験を考えてみます。分化の初期には多くの遺伝子の発現変化が小さく、二つの試料間における対数比の分布が0付近に集中しているかもしれません。一方、分化が進むにつれて多数の遺伝子が活性化または抑制され、発現変化の分布が大きく広がる可能性があります。
この場合、分布の広がりそのものが、分化の進行に伴って転写状態が大きく変化したことを示す生物学的な情報です。しかし、各時点のデータを個別にZ-score化すると、分化初期の狭い分布も分化後期の広い分布も、すべて標準偏差1になります。その結果、初期の小さな変化は相対的に拡大され、後期の大きな変化は圧縮されます。分化の進行に伴って発現変化全体が大きくなったという情報は、sample-wise Z-score normalizationによって見えなくなります。
Z-score normalizationによってデータが比較しやすくなったとしても、それは測定誤差だけを選択的に除去したことを意味しません。技術的な違いと生物学的な違いの両方を、同じ方法で一律に揃えているだけです。
1色法マイクロアレイでは、Z-score化する値の意味が変わる
Affymetrix GeneChipをはじめとする1色法マイクロアレイでは、一つのマイクロアレイに一つの試料を載せ、各遺伝子のシグナル値を測定します。したがって、1色法のシグナル値をZ-score化すると、二つの試料間の発現比ではなく、一つの試料内における全遺伝子の対数変換後のシグナル分布を平均0、標準偏差1に揃えることになります。同じsample-wise Z-score normalizationという名称であっても、2色法と1色法では、標準化されている値の意味が根本的に異なります。
初期のGeneChipでは、一定の合理性があるように見えた
Affymetrix GeneChipで初期に普及したHG-U95などでは、スポット型2色法で大きな問題となっていたスポット形成の不均一性や色素間の違いなど、多くの技術的問題が改善されていました。また、現在の網羅的なマイクロアレイと比べて搭載されている遺伝子数が少なく、測定対象も当時配列情報が得られていた比較的よく知られた遺伝子に偏っていたため、非発現または低シグナルの遺伝子が占める割合も比較的低い構成でした。
このようなデータでは、シグナル値を対数変換すると、分布が一つの山に近い形に見えていました。そこで、異なるマイクロアレイから得られたシグナル値を共通の尺度で比較する方法として、sample-wise Z-score normalizationを適用することにも一定の合理性があるように見えました。ただし、分布が一つの山に見えることと、異なるサンプルが本来同じ発現分布を持つことは同じではありません。ヒストグラムの形が似ているからといって、分布の中心や広がりの違いがすべて技術的な誤差だと判断することはできません。
異なる組織の発現分布が同じである保証はない
たとえば、脳、肝臓、筋肉、血液など、性質の大きく異なる組織を比較する場合を考えてみます。これらの組織では、発現している遺伝子の種類も、強く発現している遺伝子の構成も異なります。少数の組織特異的遺伝子が非常に高く発現している組織もあれば、多数の遺伝子が比較的広い範囲で発現している組織もあり得ます。このようなサンプルについて、全遺伝子のシグナル分布が本来同じであると考える生物学的な根拠はありません。
それにもかかわらず、各サンプルを平均0、標準偏差1に揃えると、組織ごとの生物学的な性質に由来する分布の違いまで、技術的な差として除去されます。sample-wise Z-score normalizationは、サンプル間の発現分布が同じであることを確認する方法ではありません。発現分布を同じ中心と広がりへ強制的に変換する方法です。
網羅性が高まると、分布は一つの集団ではなくなる
GeneChip HG-U133 Plus 2.0のように、より多くの転写産物を測定するマイクロアレイでは、その試料で明確に発現している遺伝子だけでなく、発現していない遺伝子や、検出限界に近い低いシグナルを示すprobe setも多数含まれるようになります。その結果、対数変換後のシグナル値の分布には、背景または低シグナルの集団と、明確な発現を示す集団が現れ、一つの山ではなく、低シグナル群と発現群が重なった複雑な形になります。
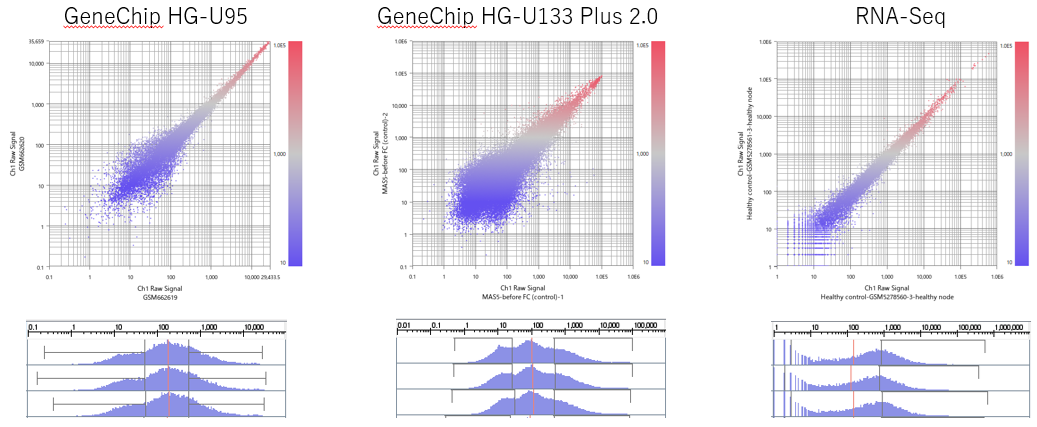
図:GeneChipの網羅化とRNA-Seqへの移行に伴う、遺伝子発現値分布の変化の例。
左から、GeneChip HG-U95、GeneChip HG-U133 Plus 2.0、RNA-Seqについて、上段にサンプル間の散布図、下段に各サンプルの値の分布を示します。HG-U95では比較的まとまった単峰性に近い分布が見られる一方、HG-U133 Plus 2.0では低シグナルのprobe setが増え、低シグナル群と発現群の違いがより明瞭になります。RNA-Seqでは、ゼロおよび低Countsの遺伝子がさらに多く含まれ、低値側に離散的なピークが現れます。各測定法の値は同じ尺度ではなく、全遺伝子を一つの均質な分布として扱う前提が、測定対象の網羅化に伴って成り立ちにくくなることを概念的に比較するために示しています。
このような分布を一つの均質な集団とみなし、単一の平均と標準偏差でZ-score化することには問題があります。二つの集団をまとめて計算した平均は、低シグナル集団の中心でも、発現集団の中心でもありません。また、標準偏差は、それぞれの集団内のばらつきだけでなく、二つの集団の中心がどれだけ離れているかにも大きく影響されます。したがって、その平均と標準偏差から計算したZ-scoreが、生物学的に明確な基準を持つとは限りません。
Z-score自体は、元の分布が正規分布でなくても計算できます。しかし、性質の異なる複数の集団を一つの分布とみなし、単一の平均と標準偏差で代表させることに意味があるとは限りません。
1色法では、quantile normalizationも提案された
1色法マイクロアレイでは、sample-wise Z-score normalizationよりも強力にサンプル間の分布を揃える方法として、quantile normalizationも提案されました。sample-wise Z-score normalizationが各サンプルの平均を0、標準偏差を1に揃えるのに対して、quantile normalizationは各サンプルに含まれる値の分布全体を同じ形に変換します。したがって、quantile normalizationを適用すると、正規化後のすべてのサンプルはヒストグラム上で同じ分布を持つようになります。一見すると、Z-score normalizationよりもさらに強力で完全な正規化に見えます。
しかし、分布を強力に揃えれば、遺伝子発現データが正しく比較できるようになるとは限りません。
quantile normalizationが抱える根本的な矛盾
quantile normalizationが妥当であるためには、サンプル間に観察される発現分布の違いが主として技術的なものであり、本来の生物学的な発現分布はおおむね同じであるという前提が必要です。しかし、ここには根本的な矛盾があります。本来の発現分布がサンプル間でほぼ同じであり、測定も安定しているのであれば、quantile normalizationを適用してもデータはそれほど大きく変わりません。そのようなデータでは、そもそも分布全体を強制的に揃える必要性が高くありません。
一方、サンプル間で分布が大きく異なり、quantile normalizationが必要に見える場合には、その違いが技術的な要因だけでなく、組織、細胞状態、分化、疾患、薬剤応答などの生物学的な違いを反映している可能性があります。その場合には、本来の発現分布は同じであるというquantile normalizationの前提が成立しません。つまり、quantile normalizationの前提が成立するデータでは強力な分布補正を必要とせず、強力な分布補正を必要とするように見えるデータでは、その前提が崩れている可能性があります。
これは、平均と標準偏差を揃えるsample-wise Z-score normalizationについても同じです。どちらの方法も、サンプル間に存在する分布の違いが技術的なものか生物学的なものかを判断していません。違いの理由を確認しないまま、分布の中心や広がり、あるいは分布全体を同じ形へ変換しているだけです。
分布を整形しても、データ内部のバイアスは除去できない
さらに、quantile normalizationによってすべてのサンプルのヒストグラムを同じ形にしても、データ内部に存在するバッチ効果が除去されるとは限りません。バッチ効果は、すべての遺伝子を一様に高くしたり低くしたりするわけではなく、特定の遺伝子群、特定のシグナル領域、特定の配列特性を持つprobe setなどに偏って現れるのが普通です。そのため、各サンプルの分布全体が完全に同じになった後でも、PCAやクラスタリングでは、生物学的な条件ではなく、実験日、試薬ロット、測定施設、装置などの違いによってサンプルが分離することがあります。
これはsample-wise Z-score normalizationについても同じです。平均と標準偏差を揃えても、どの遺伝子がどの方向に偏っているかというデータ内部の構造は残ります。先ほどの図でも、下段に示したサンプル全体の分布だけを同じ形に変換したとしても、上段の散布図に現れる遺伝子ごとの偏りや内部構造が正しく修復されるとは限りません。サンプルの分布を揃えるだけでは、データ内部に存在する技術的なバイアスを除去することはできません。
正規化に期待されるのは、技術的な違いを除去しながら、生物学的な違いを保存することです。しかし、分布を揃える処理だけでは、どの違いが技術的で、どの違いが生物学的なのかを識別できません。その結果、除去すべき技術的な偏りが残る一方で、保存すべき生物学的な違いが失われる可能性があります。正規化法を評価するときには、正規化後の分布がきれいに揃ったかどうかではなく、消すべき違いが実際に消え、残すべき違いが保存されたかを確認する必要があります。
その判断の前提として、そもそも発現データのどの領域を信頼できるシグナルとして扱えるのか、ノイズがどこにあり、再現性やダイナミックレンジをどのように考えるべきかを理解しておくことも重要です。こうした発現データの品質を考える基本的な視点については、良い遺伝子発現データとは?|ノイズ・再現性・ダイナミックレンジを理解するで詳しく説明しています。
RNA-Seqでは一般的な正規化法ではなくなった
RNA-Seqが普及して以降、sample-wise Z-score normalizationやquantile normalizationは、一般的な正規化法として扱われなくなりました。RNA-Seqでは、ライブラリーサイズやRNA compositionなどを考慮した正規化法が一般的に用いられます。ただし、RNA-Seqデータに対してsample-wise Z-score normalizationをあえて適用しようとする場合には、GeneChip HG-U133 Plus 2.0のような網羅的マイクロアレイに適用する場合と、ほぼ同じ注意が必要です。
それでも、分布を揃えるという問題は変わらない
この問題は、RNA-Seqを使った実際の発現データでも確認できます。GSE159751を用いた解析例では、サンプル間で大きく異なっていたFPKMの分布に対してquantile normalizationを適用しました。その結果、ヒストグラム上では各サンプルの分布が同じ形に揃ったように見えましたが、クラスタリングで確認すると、分布を揃えただけでは生物学的な比較に適したデータにはなっていないことが分かります。
繰り返しになりますが、分布の形を揃えることと、比較可能なデータを作ることは同じではありません。
まとめ:分布を揃えることは、正規化の目的ではない
sample-wise Z-score normalizationは、技術的なばらつきが大きかった初期のマイクロアレイ解析において、異なるデータを共通の尺度へ置き換える方法として一定の意味を持っていました。しかし、2色法から1色法へ移行すると、Z-score化される値の意味は大きく変わりました。さらに、測定対象が網羅的になるにつれて、非発現・低シグナルの遺伝子と明確に発現する遺伝子が混在するようになり、全遺伝子を一つの分布として扱う前提も成り立ちにくくなりました。
その後、分布全体を同じ形にするquantile normalizationも使われましたが、分布を揃えても、データ内部に存在するバッチ効果や遺伝子ごとの技術的な偏りを除去できるとは限りません。正規化の目的は、サンプルの分布をきれいに揃えることではありません。技術的な違いを抑えながら、解析対象となる生物学的な違いを保存することです。
分布を揃える処理が必要に見えるほどサンプル間の分布が異なる場合には、その違いを技術的なものとして消してよいという前提自体を、まず疑う必要があります。これまでも、よりよい正規化を目指してさまざまな方法が提案されてきました。これからも新しい方法が現れ、広く使われるようになるでしょう。
しかし、正規化後のヒストグラムがきれいに揃ったことだけで、その処理が正しかったと判断することはできません。PCA、クラスタリング、各遺伝子の発現パターン、サンプル情報などを組み合わせ、除去すべき違いが消え、保存すべき違いが残っているかを確認する必要があります。