RNA-Seqの標準的な解析手順では、サンプルの品質やバッチエフェクトの影響を調べるために、PCAで発現プロファイルの全体像を俯瞰します。でも、QCレポートに出てくるPCAを眺めるだけで終わっていないでしょうか。
一部のサンプルが他から離れて見え、しかもそれが研究目的に沿った分かれ方に見えると、期待した生物学的な違いを捉えたと解釈したくなります。しかし、その分かれ方が何に由来し、解析結果をどの程度左右しているかは、結論を出す前にきちんと検証する必要があります。
研究対象の条件と実験日などの技術的要因が完全に重なっていれば、交絡の存在には気づきやすいでしょう。しかし、現実のデータでは、複数の要因が部分的に重なったり、同じ条件の中に異なるサンプル群が見えたりすることもあります。公共データの再解析では、詳しい実験情報が得られないこともあります。そうした場合も、判断が難しいからといって検討を止めず、サンプル群を含めた場合と除いた場合の結果を比較しながら、データに即した解析方針と解釈を探っていくことが重要です。
本記事では、健常対照者(Healthy Control、HC)と多発性硬化症患者(Multiple Sclerosis、MS)のCD19陽性B細胞から得られた公開RNA-SeqデータGSE173789を用い、発現分布、PCA、階層型クラスタリング、個々の遺伝子の発現パターンを行き来しながら、サンプル群の特徴を調べます。さらに、サンプル構成を変えて発現変動遺伝子(DEG)とエンリッチメント解析の結果を比較し、特定のサンプル群を含めるかどうかで、解析結果とそこから導く結論がどの程度変わるかを検証します。
以下では、動画で行った検証の流れと、そこから考えられることを整理します。本記事の解析には、著者がGEOに登録したCPMデータを使用しています。
正規化後の値をそのまま信用せず、分布の形を確認する
Subio Platform では、実験パラメーターと値分布を表すヒストグラムを同じテーブル上で確認できます。ヒストグラムで各サンプル内の遺伝子の値の分布を確認し、PCAや階層型クラスタリング、ライングラフでサンプル間の発現プロファイルを見比べることで、異なる見方を結びつけながらデータの特徴を調べます。
今回の公開CPMデータでは、一部のサンプルで低いCPM値が乏しく、ヒストグラムの左側に空白が見られるなど、他のサンプルとは大きく異なる分布が見られました。CPM(Counts Per Million)は、遺伝子のカウントをライブラリサイズに応じて換算した値です。換算に用いる総カウント数が非常に少ないサンプルでは、わずかなGene Countsでも比較的大きなCPM値になります。そのため、ゼロを除く低値域に値が入りにくくなり、ヒストグラムの左側に空白が生じます。このことが、今回の分布の特徴を生んだ有力な原因と考えられます。
実際に、PCAで他から外れて見えるサンプルの多くは、SRA(Sequence Read Archive)上で確認できるリード数やFASTQファイルサイズが比較的小さいサンプルと、おおむね一致していました。具体的には、MS-13、MS-16〜MS-19、HC-19などで、この対応が見られました。ただし、両者は一対一に対応しているわけではありません。遺伝子に割り当てられるリード数には、総リード数だけでなく、QCフィルタリングの通過率、マッピング率、遺伝子への割り当て率なども関与しうるためです。
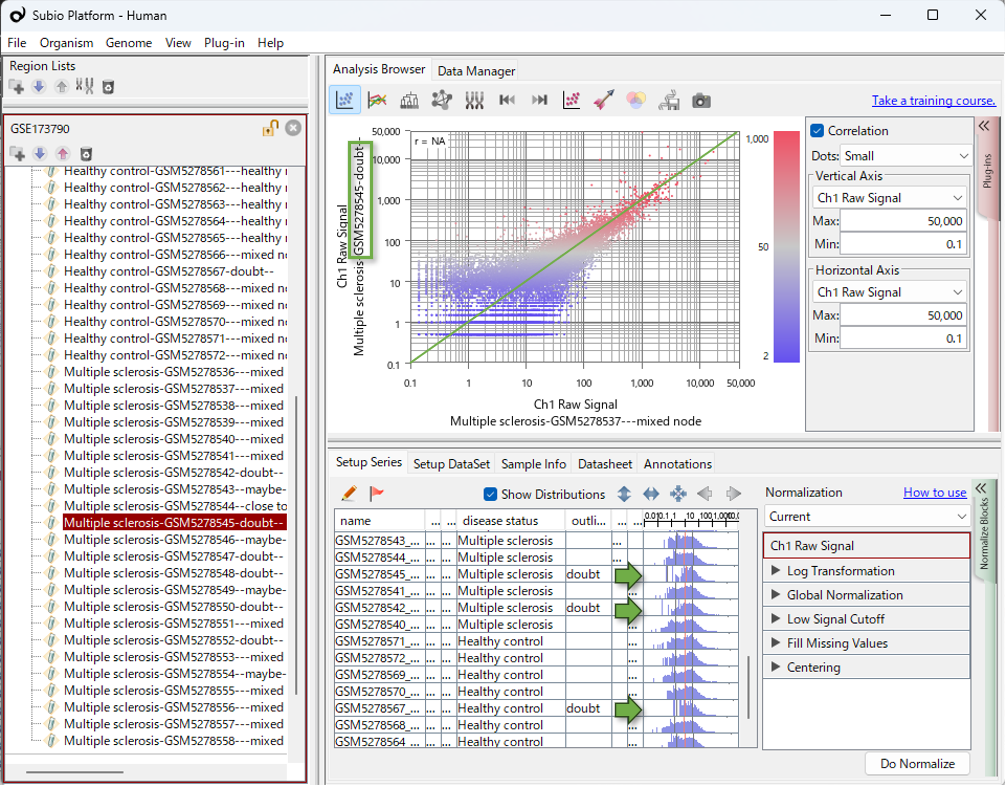
本記事では、一部のサンプルで低値域が乏しくなるなど、他のサンプルとは異なる分布形状を「分布の歪み」と呼びます。
サンプルの構成によって、DEGとエンリッチメント結果は大きく変わる
では、こうしたサンプル群を含めるかどうかで、Healthy ControlとMSの比較結果はどの程度変わるのでしょうか。
動画では、まずPCAのPC1方向に大きく離れて位置する7サンプルを特定しました。次に、階層型クラスタリングでこれらと同じクラスターに属する6サンプルを加え、計13サンプルを除いた比較を行いました。この13サンプルの内訳はHCが2、MSが11で、MS側に大きく偏っていました。このサンプル群の偏りが疾患による群分けと交絡し、このサンプル群に特徴的な発現パターンと、疾患に伴う発現差とを区別しにくい構成になっていました。
残った24サンプルでは、今度はHealthy Controlの6サンプルがまとまり、それ以外のHealthy ControlとMSを含むクラスターから分かれて見えました。 そこで、この6サンプルをさらに除いた比較も行ったところ、DEGの内容とエンリッチメント解析の結果は再び大きく変わりました。最初に目立ったサンプル群を除けば問題が解消するわけではなく、その後に見える別のサンプル構造も、解析結果を左右していたのです。
DEGの判定とエンリッチメント解析は、三つの比較でそれぞれ同じ条件を用いました。 各比較のサンプル数と、MSで発現が高いと判定された遺伝子数は、次のとおりです。
サンプル構成によるUP遺伝子数の変化
| 解析対象 | HC サンプル数 |
MS サンプル数 |
UP遺伝子数 |
|---|---|---|---|
| 全サンプル | 14 | 23 | 586 |
| 分布に歪みのある13サンプルを除外 | 12 | 12 | 1,297 |
| 上記13サンプルに加え、HC内の6サンプルのクラスターを除外 | 6 | 12 | 336 |
UP遺伝子数:HCと比較してMSで発現が高いと判定された遺伝子の数。
三つのUPリストすべてに共通する遺伝子は54個でした。 エンリッチメント解析で得られるGO term(遺伝子の機能などを分類した項目)も、解析対象とするサンプル構成によって変わりました。
13サンプルを除くと、UP遺伝子数は586から1,297へ増えました。歪みのあるサンプルは、見せかけの発現差を生む可能性も、本来ある発現差を見えにくくする可能性もあります。したがって、この増加は歪みの影響と矛盾しません。歪みのあるサンプルを除いたことで、本来発現差のある遺伝子が、より多く検出されるようになった可能性もあります。 ただし、増えたという事実だけで、その結果が正しいと判断できるわけではありません。
さらにHC内の6サンプルを除くと、UP遺伝子数は336となり、遺伝子リストの内容とエンリッチメント解析の結果も変わりました。この6サンプルを含めた比較では、HCとMSの差に、この6サンプルとそれ以外のサンプルとの差が重なっています。そのため、抽出されるDEGは、この6サンプルに特徴的な発現パターンに大きく左右されます。一方、この6サンプルを除くと、残ったHCとMSの発現プロファイルは比較的均一で、発現変動が乏しくなります。つまり、ここでも疾患による群分けと、異なる発現プロファイルを持つサンプル群の偏りが交絡し、比較結果を大きく左右していたと考えられます。
今回の比較では、MS側に偏った分布の歪みを持つサンプル群と、HC内で異なる発現プロファイルを持つ6サンプルの両方が、HCとMSの差を大きく左右していました。そのため、得られたDEGをそのまま疾患による発現変動と解釈することはできません。ただし、結果への影響が大きいことと、そのサンプル群を除外すべきことは別の判断です。ここでは背景情報が限られるため、除外の是非までは断定しません。それでも、サンプル構成による結果の変化や個々の遺伝子の発現パターンから、どのような解析方針が妥当かを検討することはできます。
また、PCAで外れて見えても、DEGへの影響がほとんどない場合もあります。データごとに影響の程度を検証し、そのうえで、結果を左右するサンプル群の特徴が何に由来するのか、研究目的に照らしてどう扱うかを検討するとよいでしょう。
HC内で分かれた6サンプルをどう解釈するか
では、分布に歪みのある13サンプルを除いた後に見えてきたHealthy Control内の6サンプルのまとまりを、どう捉えればよいのでしょうか。解析結果を大きく左右することは分かりましたが、それだけで除外すべきかどうかは決まりません。
この6サンプルのIDはGSM5278560〜GSM5278565で、連番になっています。発現プロファイルの類似性とサンプルIDの連続性が重なることは、バッチエフェクトの可能性を念頭に置く理由になります。ただし、それだけで結論づける前に、少なくとも二つの可能性を検討する必要があります。
可能性1:生物学的な不均一性を反映している
Healthy Controlの中に、異なる生物学的背景を持つサンプルが含まれており、その違いが発現プロファイルとして現れている可能性があります。たとえば、年齢、性別、炎症状態、既往歴、細胞サブセットの構成比などが影響しているかもしれません。この場合、Healthy Controlの分離は、解析上重要な情報を含んでいる可能性があります。 したがって、十分な根拠なく除外することは避けるべきです。
可能性2:実験的・技術的な要因による偏りを反映している
一方で、Healthy Controlの分離が、ライブラリ調製、シーケンスラン、サンプル処理日、保存状態、RNA品質、またはその他の技術的要因によって生じている可能性もあります。この場合、見えている差は生物学的な疾患差ではなく、データ取得や処理の過程で生じた偏りを反映している可能性があります。
解析アルゴリズムだけで判断できるものではない
サンプル構成を変えた比較によって、結果への影響は分かります。しかし、それだけで、どのサンプル構成が研究目的に適しているかまで自動的に決まるわけではありません。HC内の6サンプルのクラスターについても、生物学的な不均一性と技術的な偏りのどちらを考えるかで、扱い方が変わります。
このような状況では、「どの統計手法を使えば解決できるか」だけを考えても十分ではありません。 解析方法によって構造の見え方が変わっても、その原因が説明されたことにはならないからです。判断材料になるのは、Healthy Controlの臨床的背景、サンプル採取条件、ライブラリ調製日、シーケンスラン、RNA品質、実験ノートなど、計算結果の外側にある情報です。
公共データの再解析では、こうした情報が十分に得られず、すべての疑問に明確な答えを出せないこともあります。その場合も、サンプル構成を変えた比較を通じて、どの結果が変わり、どの結果が共通して残るのかを整理できます。そのうえで、利用可能な情報に基づいて解析方針を選び、どのような前提で解析を行ったのかを明示することが重要です。
同様の問題は、ほかの公開データでも繰り返し見られる
RNA-Seq解析では、広く使われている標準的なツールやプロトコルに従うことが、信頼性の高い解析につながると考えられがちです。確かに、ツールの特徴や限界を自分で評価できない場合には、利用実績や評判を参考にすることも一つの選択肢です。今回の原著論文でも、GEOの登録情報によれば、Gene CountsからCPMへの変換に広く利用されているedgeRが使われています。DEG解析にもedgeRが使われた可能性はありますが、その点については確認できていません。
いずれにせよ、標準的なツールを使うことが解析結果の信頼性を保証するわけではありません。このデータを報告した原著論文のFig. 4AおよびFig. 4Bにも、本記事の再解析で確認したものと似たサンプル構造が現れています。そして、本文と補足資料には、これらのサンプル群を含めるかどうかによってDEGやエンリッチメント解析の結果がどの程度変わるかを検討した記述は見当たりません。
私がこれまで公開データを解析してきた中でも、特定のサンプル群が比較結果を大きく左右する構造がある一方で、その影響について論文中で検討されていない例に繰り返し出会ってきました。こうした状況が繰り返される背景には、個々の解析者の注意だけでは説明できない構造的な要因があるのではないかと考えました。
そこで、同じデータをGalaxy、RaNA-Seq、RNAseqChef、iDEPで解析し、各工程でどのようなQC情報や可視化が提供され、その情報をサンプル構造や比較結果と結びつけて検討することがどの程度容易なのかを、実際の操作を通じて調べました。
GalaxyとRaNA-Seqでは、FASTQからGene Countsを作成するところから再解析しました。それぞれのQCレポートでは、リード数や遺伝子に割り当てられたリード数(Assigned reads)などにサンプル間の違いがあり、作成したGene CountsをSubio Platformで確認すると、公開CPMで観察した分布の特徴が再び現れることも確認できました。これらは、本記事のCPMデータでの検討を受けて行った、追加の検証です。
標準的な解析の流れの中で、なぜこうした構造を見過ごしうるのか。そして、気づいた違いを解析結果への影響の検証につなげられるか。 その検証過程を、次のシリーズ記事で紹介します。
正規化・バッチエフェクト補正による追加検証:
このケーススタディで観察されたサンプル構造について、TMM、DESeq2 VST、Quantile normalization、ComBatなどを用いてさらに検討しました。
RNA-Seqのバッチエフェクト補正と正規化の限界
解析者の仕事とは
以上は、私がこのデータと向き合う中で感じ、考えたプロセスを言語化したものであり、これが唯一の正解だと主張するものではありません。私が伝えたいのは、データを見ながら複数の可能性を考え、実際に比較し、解釈の分岐点を明確にすることの重要性です。
一つの可能性に絞り込めない場合には、それぞれのシナリオに基づく解析結果を整理し、チームリーダー、実験担当者、臨床医、病理医など、データの背景を知る人たちと議論できる形で提示する必要があります。
高度な統計解析を使いこなすことだけが、オミクスデータ解析の本質ではありません。データを可視化し、前提を確認し、データの特徴と解析結果を丁寧に説明することも、解析者の重要な仕事です。
解析を学ぶということ
「データ解析を学ぶ」ということは、実際に多様なデータセットと向き合い、可視化し、仮説を立て、確認しながら判断する経験を積み重ねることです。当然ながら、一朝一夕に身につくものではなく、相応の時間と根気を必要とする長い道のりです。
Subioが提供する成長のステップ
Subioでは、お客様が実際に扱っているデータを用い、共に解析を進めるオンライン・トレーニング を通じて、実践的な学びを提供しています。個人差はありますが、概ね1年をかけて3〜6回程度のマンツーマン個別セッションを重ねることで、ご自身のデータを題材にしながら、解析の考え方や判断の進め方を着実に身につけていくことができます。
一方で、すぐに解析結果を得たい方や、まずは専門的な視点でデータの状態を確認したい方には、データ解析サービス をお勧めします。Subioのデータ解析サービスは、単に結果レポートを納品するだけの受託解析サービスではありません。お客様にデータの特徴や解析ステップを理解していただき、そのうえで、お客様自身が判断し、結論を出すための材料を整理するサービスです。
ご興味を持っていただけましたら、お気軽にご相談ください。
学ぶべきは、コマンド操作やツールの使い方だけではありません。
本当に学ぶべきなのは、「データ解析」そのものです。