本記事では、GSE173789の、健常対照者(Healthy Control、HC)と多発性硬化症患者(Multiple Sclerosis、MS)から採取したCD19陽性B細胞のRNA-Seqデータを用います。サンプル間の発現分布と発現プロファイルの違いに注目し、それらの特徴を持つサンプル群を含めるかどうかによって、Healthy ControlとMSの比較結果がどの程度変わるかを検証します。
ヒストグラム、PCA、階層型クラスタリング、個々の遺伝子の発現パターンを行き来しながら、発現変動遺伝子(DEG)のリストとエンリッチメント解析の結果を比較しました。ここで検証するのは、観察されたサンプル構造に対する解析結果の依存性です。
「同じ条件のサンプルなのに、なぜか群間差よりもサンプル間のバラツキが大きく見える……」
オミクス解析で検討が必要になる問題の一つが、バッチエフェクトです。これは、実験日やライブラリ調製など、処理単位の違いに伴う技術的な偏りを指します。ただし、サンプルが他から離れて見えることだけで、バッチエフェクトと判断することはできません。本記事では、実際のデータを用いて、補正を行う前に、まず「データの中で何が起きているのか」を可視化しながら確認する方法を紹介します。
正規化後の値をそのまま信用せず、分布の形を確認する
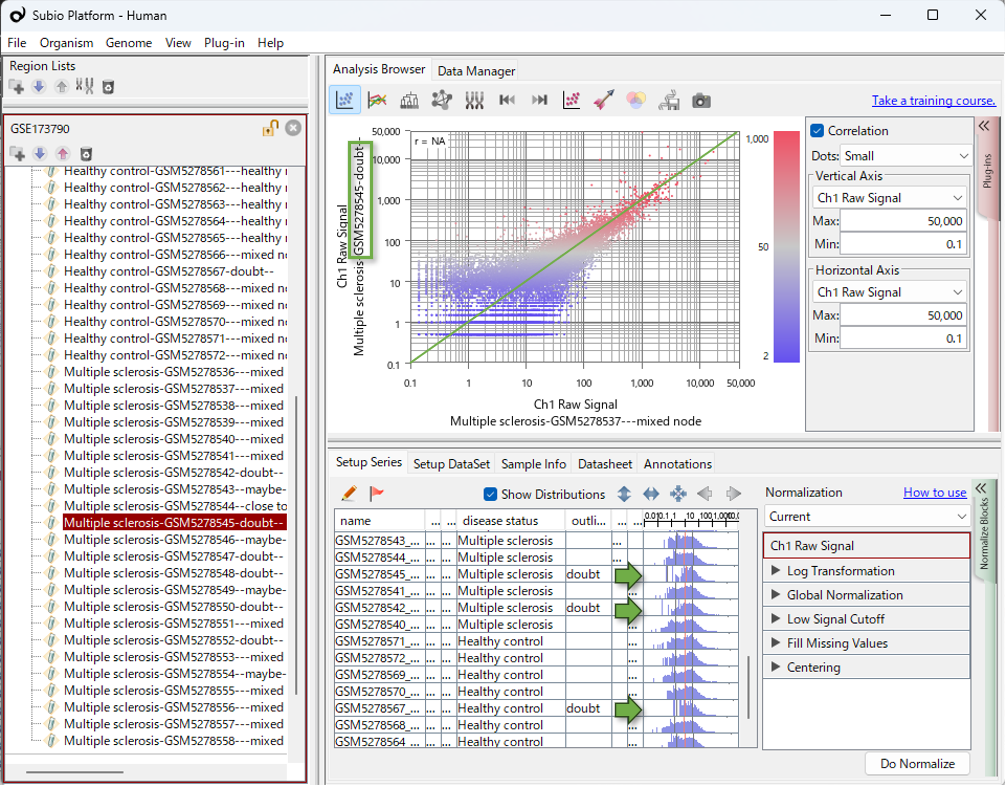
Subio Platform では、実験パラメーターと値分布を表すヒストグラムを同じテーブル上で確認できるため、データの分布と実験パラメーターの間に関連がありそうかどうかを、視覚的に確認しやすくなっています。ヒストグラムでは各サンプル内の遺伝子の値の分布を確認し、PCAやクラスタリング、ライングラフではサンプル間の発現プロファイルを見比べます。
今回の公開CPMデータでは、一部のサンプルで低いCPM値が乏しく、他のサンプルとは異なる分布が見られました。CPM(Counts Per Million)は、遺伝子のカウントをライブラリサイズに応じて換算した値です。PCAで他から離れて見えるサンプルの多くは、SRA(Sequence Read Archive)上で確認できるリード数やFASTQファイルサイズが比較的小さいサンプルと、おおむね一致していました。特に、MS-13、MS-16〜MS-19、HC-19では、その傾向が明確に見られます。
その後、GalaxyとRaNA-Seqを使い、FASTQを取得し直してGene Countsを作成するところから再解析しました。それぞれのQCレポートでも、FASTQファイルサイズ、リード数、遺伝子に割り当てられたリード数(Assigned reads)などに、サンプル間の違いがあることを確認しました。QCレポートとGene Countsの詳しい検討は、Galaxyによる解析の記事とRaNA-Seqの出力を検討した記事で紹介しています。
作成したGene CountsをSubio Platformで確認すると、該当するサンプルでは、正規化前の値が低い領域に集中していました。正規化によって値が引き上げられると、分布は右方向へ移動し、正規化後のヒストグラムでは低値域の値が乏しくなりました。公開CPMで観察した分布の特徴は、FASTQから作り直したデータでも確認できました。
本記事では、一部のサンプルで低値域が乏しくなるなど、他のサンプルとは異なる分布形状を「分布の歪み」と呼びます。ただし、その原因や、該当するサンプルが異常値かどうかについては判断しません。
サンプル間の分断は一段階では終わらないこともある
動画で示した通り、分布に歪みのあるサンプル群を除くと、今度はHealthy Controlの6サンプルがまとまり、それ以外のHealthy ControlとMSを含むクラスターから分かれて見えました。 このように、発現プロファイルによるサンプル間の分断は、一段階で終わるとは限りません。
この6サンプルのIDはGSM5278560〜GSM5278565で、連番になっています。発現プロファイルの類似性とサンプルIDの連続性が重なることは、バッチエフェクトの可能性を念頭に置く理由になります。ただし、それだけで結論づける前に、少なくとも二つの可能性を検討する必要があります。
可能性1:生物学的な不均一性を反映している
Healthy Controlの中に、異なる生物学的背景を持つサンプルが含まれており、その違いが発現プロファイルとして現れている可能性があります。たとえば、年齢、性別、炎症状態、既往歴、細胞サブセットの構成比などが影響しているかもしれません。この場合、Healthy Controlの分離は、解析上重要な情報を含んでいる可能性があります。 したがって、十分な根拠なく除外することは避けるべきです。
可能性2:実験的・技術的な要因による偏りを反映している
一方で、Healthy Controlの分離が、ライブラリ調製、シーケンスラン、サンプル処理日、保存状態、RNA品質、またはその他の技術的要因によって生じている可能性もあります。この場合、見えている差は生物学的な疾患差ではなく、データ取得や処理の過程で生じた偏りを反映している可能性があります。
解析アルゴリズムだけで判断できるものではない
このような状況では、「どの統計手法を使えば解決できるか」だけを考えても十分ではありません。 解析方法によって構造の見え方が変わっても、その原因が説明されたことにはならないからです。必要になるのは、計算結果の外側にある情報です。たとえば、Healthy Controlの臨床的背景、サンプル採取条件、ライブラリ調製日、シーケンスラン、RNA品質、リード数、実験ノートなどを確認することで、見えている構造が生物学的な違いなのか、技術的な偏りなのかを検討します。
それでも、すべての疑問に明確な答えが得られるとは限りません。その場合、解析者は利用可能な情報に基づいて前提を明確にし、その前提に沿って解析方針を選ぶ必要があります。重要なのは、判断を避けることではなく、どのような前提で解析を行ったのかを明示することです。 どちらの解釈を採用する場合でも、その前提が解析結果の意味づけに大きく影響します。
オミクスデータ解析では、完全に機械的な手順だけで結論に到達できるとは限りません。可視化によってデータの状態を確認し、必要に応じて背景情報を調べ、そのうえで解析者が自覚的に判断することが重要です。このような丁寧な解析は、原理的にはどのような解析ツールを使っても可能です。しかし、実際によく使われるパイプラインで解析してみると、それを現実に行うことが必ずしも容易ではないことも分かります。
サンプルの構成によって、DEGとエンリッチメント結果は大きく変わる
動画では、まずPCAのPC1方向に大きく離れて位置する7サンプルを特定しました。次に、階層型クラスタリングでこれらと同じクラスターに属する6サンプルを加え、計13サンプルを除いた比較を行いました。残った24サンプルでは、Healthy Controlの6サンプルが、それ以外のHealthy ControlとMSを含むクラスターから分かれていました。そこで、このHealthy Controlの6サンプルをさらに除いた比較も行いました。
DEGの判定とエンリッチメント解析は、三つの比較でそれぞれ同じ条件を用いました。 各比較のサンプル数と、MSで発現が高いと判定された遺伝子数は、次のとおりです。
サンプル構成によるUP遺伝子数の変化
| 解析対象 | HC サンプル数 |
MS サンプル数 |
UP遺伝子数 |
|---|---|---|---|
| 全サンプル | 14 | 23 | 586 |
| 分布に歪みのある13サンプルを除外 | 12 | 12 | 1,297 |
| 上記13サンプルに加え、HC内の6サンプルのクラスターを除外 | 6 | 12 | 336 |
UP遺伝子数:HCと比較してMSで発現が高いと判定された遺伝子の数。
三つのUPリストすべてに共通する遺伝子は54個でした。 エンリッチメント解析で得られるGO term(遺伝子の機能などを分類した項目)も、解析対象とするサンプル構成によって変わりました。
これは、サンプルを除けばDEGが単純に減るという結果ではありません。特定のサンプル群を含めるかどうかによって、検出される遺伝子の数と内容、そこから得られる生物学的な解釈が大きく変わることを示しています。
同様の問題は、ほかの公開データでも繰り返し見られる
このデータを報告した原著論文のFig. 4AおよびFig. 4Bにも、本記事の再解析で確認したものと似たサンプル構造が現れています。しかし、本文と補足資料には、これらのサンプル群を含めるかどうかによってDEGやエンリッチメント解析の結果がどの程度変わるかを検討した記述は見当たりません。私がこれまで公開データを解析してきた中でも、特定のサンプル群が比較結果を大きく左右する構造がある一方で、その影響について論文中で検討されていない例に繰り返し出会ってきました。こうした状況が繰り返される背景には、個々の解析者の注意だけでは説明できない構造的な要因があるのではないかと考えました。
そこで、同じデータをGalaxyとRaNA-SeqでFASTQから解析し直しました。各工程でどのようなQC情報が示されるのか、その情報を発現プロファイルや比較結果と結びつけて判断することがどの程度容易なのかを、実際の操作を通じて検討しました。標準的な解析の流れの中で、なぜこうした構造を見過ごしうるのか。 その検証過程を、Galaxyによる解析の記事とRaNA-Seqによる解析の記事で紹介します。
解析者の仕事とは
以上は、私がこのデータと向き合う中で感じ、考えたプロセスを言語化したものであり、これが唯一の正解だと主張するものではありません。私が伝えたいのは、データを見ながら複数の可能性を考え、解釈の分岐点を明確にすることの重要性です。一つの可能性に絞り込めない場合には、それぞれのシナリオに基づく解析結果を整理し、チームリーダー、実験担当者、臨床医、病理医など、データの背景を知る人たちと議論できる形で提示する必要があります。
高度な統計解析を使いこなすことだけが、オミクスデータ解析の本質ではありません。データを可視化し、前提を確認し、データの特徴と解析結果を丁寧に説明することも、解析者の重要な仕事です。
解析を学ぶということ
「データ解析を学ぶ」ということは、実際に多様なデータセットと向き合い、可視化し、仮説を立て、確認しながら判断する経験を積み重ねることです。当然ながら、一朝一夕に身につくものではなく、相応の時間と根気を必要とする長い道のりです。
Subioが提供する成長のステップ
Subioでは、お客様が実際に扱っているデータを用い、共に解析を進めるオンライン・トレーニングを通じて、実践的な学びを提供しています。個人差はありますが、概ね1年をかけて3〜6回程度のマンツーマン個別セッションを重ねることで、ご自身のデータを題材にしながら、解析の考え方や判断の進め方を着実に身につけていくことができます。
一方で、すぐに解析結果を得たい方や、まずは専門的な視点でデータの状態を確認したい方には、データ解析サービスをお勧めします。Subioのデータ解析サービスは、単に結果レポートを納品するだけの受託解析サービスではありません。お客様にデータの特徴や解析ステップを理解していただき、そのうえで、お客様自身が判断し、結論を出すための材料を整理するサービスです。
ご興味を持っていただけましたら、お気軽にご相談ください。
学ぶべきは、コマンド操作やツールの使い方だけではありません。
本当に学ぶべきなのは、「データ解析」そのものです。
続編記事:
このケーススタディで観察されたサンプル構造について、TMM、DESeq2 VST、Quantile normalization、ComBatなどを用いてさらに検討しました。
RNA-Seqのバッチエフェクト補正と正規化の限界