RNA-Seqの発現差解析では、DESeq2やedgeRのように、 負の二項分布を前提とした統計モデルが広く使われています。 一方、t検定については、 「RNA-Seqには使うべきではない」 「カウントデータには不適切」 と説明されることが少なくありません。
この説明は、特に生のcount値をそのままt検定にかけるような 誤用を防ぐという意味で有用です。 生カウントデータには0や1が多い低発現領域があり、 平均値と分散の関係や過分散も無視できません。 負の二項分布モデルは、こうしたデータの性質を扱い、 遺伝子間の情報を利用して分散推定を安定させるという利点があります。
しかし、適切な正規化、低発現遺伝子のフィルタリング、 対数変換などを行い、データの分布やサンプル間の関係を確認した場合には、 議論の前提が変わります。 解析対象は、すでに生のcount値そのものではありません。 もちろん、前処理を行っただけでt検定の前提が自動的に満たされるわけではなく、 少サンプルでの分散推定など、edgeRやDESeq2が有利になる場合もあります。
したがって、 「負の二項分布モデルの方が本質的に正しい」 「t検定はRNA-Seqには不適切」 という単純な優劣の議論ではなく、 データの性質と各手法の前提を踏まえて考える必要があります。
なぜt検定は避けられるようになったのか
RNA-Seq解析でt検定が一般に推奨されなくなった背景には、 カウントデータの統計的な性質に加えて、 解析を安定して実行するための実務上の理由があります。 その一つが、RPKMやFPKMなど、正規化済みの発現量を そのまま統計解析に使うことの問題です。
RPKMやFPKMは、ライブラリサイズや遺伝子長で補正された値ですが、 正規化によって低カウント値そのものの信頼性が高くなるわけではありません。 raw countが1と2の違いであっても、変換後には2倍の差として見えることがあります。 このような差には、サンプリングノイズや測定上の不確かさが 強く含まれている可能性があります。
その後、TPMが登場し、FPKMやRPKMに代わって使われる場面が増えました。 TPMは遺伝子長とライブラリ内の相対的な発現量を扱ううえで便利ですが、 低カウント由来の不安定性や、発現量に依存する分散、 少サンプル条件でのばらつきを解決するものではありません。 したがって、TPMをそのまま一般的な統計検定に使うことにも注意が必要です。 また、TPMを負の二項分布モデルの入力として用いることは不適切です。
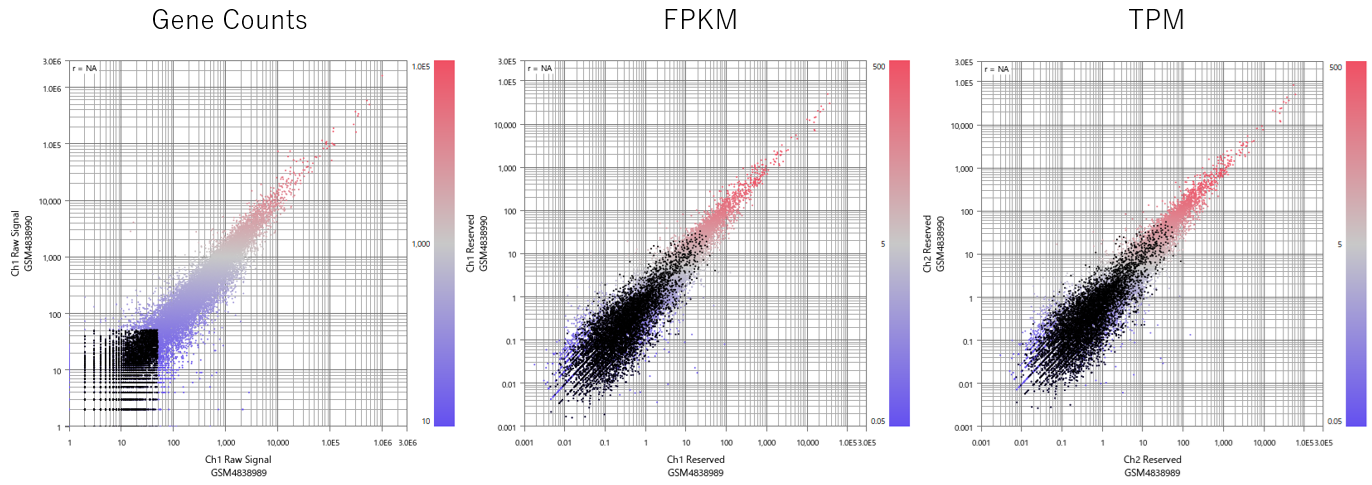
こうした問題に対応するため、DESeq2やedgeRのような RNA-Seq専用の統計手法が発展し、広く利用されるようになりました。 これらはGene Countsを入力として、 ライブラリサイズの補正、平均値と分散の関係、 少サンプルでの分散推定などを一連の枠組みで扱えます。 標準的なパイプラインに組み込みやすく、 大量のデータを効率的に解析できることも大きな利点です。
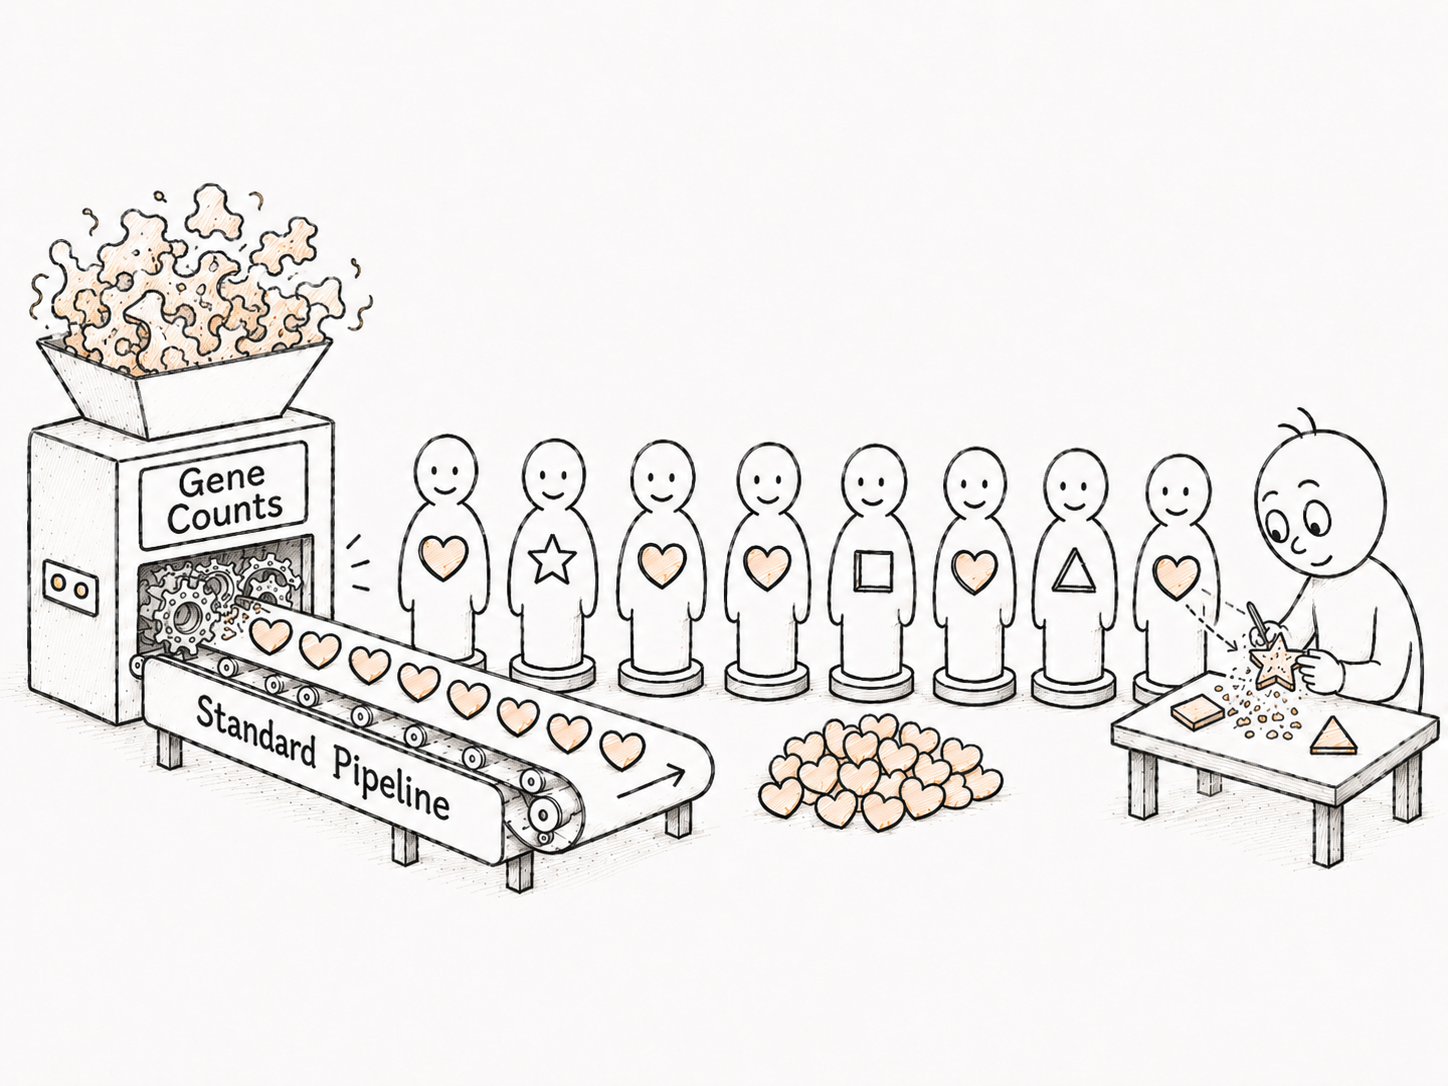
一方、Gene Countsを入力すれば標準モデルが結果を返してくれるという便利さには、 データの状態を十分に確認しないまま結果を受け取ってしまう危険もあります。 また、生カウントにt検定を直接適用することへの注意喚起が、 「t検定はRNA-Seq解析では本質的に劣った手法である」 という理解に変わってしまうと不正確です。
統計手法によって、検出される遺伝子はどう変わるのか
統計的に有意と判定された遺伝子の中には、 発現変化も群内分散も小さい遺伝子もあれば、 どちらも大きい遺伝子も含まれます。 同じ「有意なDEG」でも、その背景にある生物学的なメカニズムは異なるかもしれません。 前者は、多くの細胞に共通する小さく安定した応答かもしれませんし、 一部の細胞集団での大きな変化がBulk RNA-Seqでは希釈されている可能性もあります。 後者は、個体ごとに応答の程度が異なる場合や、 疾患サブタイプ、細胞組成の違いなどを反映しているのかもしれません。 もちろん、技術的なばらつきや外れ値の影響も考慮する必要があります。
こうした発現パターンを理解するには、 観察された結果から原因を考えるだけでなく、 生物学的なメカニズムを仮定し、 そこから予想される発現パターンを探索する というアプローチも有効です。 この記事では、複数の原因遺伝子や抑制因子が関与するモデルを例に、 原因遺伝子が必ずしも典型的なDEGとして検出されない可能性を説明しています。 そして、P値の小さい遺伝子ではなく、 有意判定の閾値付近にある遺伝子を積極的に集め、 クラスタリングによって特徴的な発現パターンを探す方法を提案しています。
このように、統計手法の理論的な妥当性だけでなく、 どのような遺伝子を検出しやすく、 どのような遺伝子を見落としやすいのか という実用性も重要になります。 具体的な手法の特徴と選択については、 edgeR・DESeq2・t検定の使い分け|原理とデータタイプ別の実践ルール で解説しています。
DESeq2やedgeRでも、偽陽性が問題になることはある
DESeq2やedgeRは標準的な統計手法ですが、 どのようなデータでも偽陽性が適切に抑えられるとは限りません。 ヒト集団由来の大規模RNA-Seqデータを対象とした研究では、 条件ラベルを入れ替えたpermutation解析により、 これらの手法で想定よりも多くの偽陽性が検出される場合があることが報告されています。 (参照:Exaggerated false positives by popular differential expression methods when analyzing human population samples)
この問題については、統計モデルへの適合不良や外れ値の影響、 FDR制御のずれなどが議論されています。 その後の研究でも、外れ値への対応や、 シミュレーションで正規化の影響をどう扱うかによって、 偽陽性の評価が変わることが指摘されています。
一方、GEOに登録された実データを使った私たちの解析では、 サンプルごとの低Counts領域の分布や実質的な検出限界の違いが、 解析結果に影響しうることも観察しています。 (ケーススタディ: No.426(中規模データで一般的に観察されるレベルの事例)、 No.403(解析結果を大きく歪めるレベルの事例))
正規化やバッチ効果補正によって、データの問題が見えにくくなることもある
正規化やバッチ効果補正は、RNA-Seqデータを適切に解析するための重要な処理ですが、 適用するだけでデータが信頼できる状態になるわけではありません。 TMM、DESeq2 VST、Quantile normalization、ComBatなどを比較し、 発現分布やクラスタ構造がどのように変化するかを調べたケーススタディでは、 補正後も問題のあるサンプルに特徴的な構造が残ることや、 一部の遺伝子群が相対的に高発現に見えることが確認されました。
重要なのは、処理前後の変化を確認し、 観察された発現パターンが何を反映しているのかを考えることです。
手作業でデータを見ることは、古いやり方ではない
手作業でデータを確認しながら解析することは、 単に古い、非効率な方法ではありません。 正規化前後の発現分布、低発現遺伝子の影響、 PCAでのサンプル分離、クラスタリングでのまとまり、 個々の遺伝子の発現パターンなどを確認することで、 自動解析の結果だけでは気づきにくい問題を発見できます。
たとえば、 PCAで実験条件ではなく実験日ごとにサンプルが分かれて見えた場合、 単純に補正アルゴリズムを適用するだけでは十分とは限りません。 また、統計モデルによるDEG判定では、 生物学的に重要かもしれない候補遺伝子が除外される こともあります。 どちらの場合も、観察されたデータから原因を考え、 必要に応じて解析方法や対象遺伝子を見直すことが重要です。
統計モデルによる自動化と研究者自身による視覚的な確認は、 対立するものではありません。 それぞれの長所を組み合わせ、 データの状態と研究目的に応じて判断することが、 現実的で信頼性の高い解析につながります。
実際のRNA-Seqデータで確認する
統計モデルを過信せず、実際のデータを確認しながら解析を進める方法は、 RNA-Seqデータ解析チュートリアル|GEOデータで学ぶ解析の流れと結果の見方 で紹介しています。 Gene Countsの取り込みから正規化、フィルタリング、PCA、 クラスタリング、発現差解析、エンリッチメント解析まで、 各段階でデータの状態を確認します。
また、 ChatGPTを使ったedgeR・DESeq2解析 では、 Subio Platform からGene Countsを出力し、ChatGPTでRスクリプトを作成して解析した後、 結果をSubio Platformに戻して可視化・検証する流れを解説しています。
こうした経験は、RNA-Seqデータの性質や解析手法の特徴を理解し、 その後の自動化戦略を考えるための土台になります。 実験研究者だけでなく、解析パイプラインやシステムを設計する バイオインフォマティシャンにとっても有用です。