以前の記事では、公開RNA-Seqデータを使い、Galaxyで標準的なRNA-Seq解析の流れを実際に実行しました。そこで確認したのは、信頼性の高い解析ツールを組み合わせ、標準的な手順に従って最後まで解析を実行できても、それだけで得られた結果の信頼性を判断できるわけではないということでした。
今回は、その続きとして同じデータをRaNA-Seq で解析してみます。RaNA-Seqは、FASTQを入力すると、Quantification、Quality Control、Differential Expression、Functional Enrichment、GSEAまでをWebブラウザ上で連続して実行できます。コーディングを必要とせず、一連の解析結果を短時間で得ることができるのが特長です。「RNA-Seq 解析ソフト」と検索すると、現在(2026年)も上位に表示される有名なツールです。ただし、Galaxyよりもさらに解析が自動化されたツールでは、何が行われたのかを確認しにくくなる分、得られた結果の信頼性を十分に検証できるのかという懸念がより大きくなります。そこで今回は、この点を実際に検証してみます。
今回も、GSE173789のデータを使いますが、これは以前のケーススタディで本来の解析目的とは異なる要因によって生じたと強く疑われる発現変動が含まれていることを確認しています 。まずはこのケーススタディ、または下記のショート解析1の動画で、このデータセットがどのような特徴を持っているのかを確認してから、この先を読み進めることをお勧めします。
RaNA-Seqは、FASTQから一連の解析を自動で実行できる
RaNA-Seqでは、FASTQを入力し、比較するサンプル群を設定すると、RNA-Seqの解析で一般的に使われるツール群を自動実行します。データインポートが終われば後の操作は非常に簡単で、解析結果を驚くほど短時間で得られます。ウェブサイト上で見る解析レポートの図は美しく、PDFに出力されるレポートも、論文で見慣れたような整ったデザインにまとめられています。ちなみに、今回の解析でRaNA-Seqから得られた主なレポートと結果ファイルはこちらからダウンロードして実際にご覧いただけます。
つまり、解析をボタン一つであっという間に実行し、それらしい完成形として提示するという点では、RaNA-Seqは非常によくできています。しかし、今回検証したいのは、その結果の信頼性を確認することができるかどうかです。
まずデータを入れるところで予想外の問題が起きた
RaNA-Seqでは、ローカルのFASTQ.gzファイルをブラウザへドラッグ&ドロップしてアップロードできます。また、ENAのStudy Accessionを指定し、公開RNA-Seqデータをまとめて取得する機能もあります。2021年に公開された紹介動画でも、この2つの方法が実演されています。しかし今回の環境では、どちらもうまく動きませんでした。 ローカルFASTQをアップロードすると途中でerrorとなり、ENAのAccessionを指定した場合も処理開始後にerrorとなりました。ウェブツールではよくあることですが、困ったのは問題解決のためのヒントがまったく表示されないことでした。
そこで、ブラウザーの検証機能を使って実装コードを確認すると、ファイルは約2 MBずつに分割して送信され、それぞれのチャンクに10秒のタイムアウトが設定されていました。また、確認した範囲では、タイムアウトしたチャンクを自動的に再試行する処理も見当たりませんでした。つまり、多数のチャンクを連続して送信する大容量FASTQで、たった一回10秒を超えるだけでファイル全体がerrorになるのです。このような条件でギガバイト単位のFASTQファイルのアップロードを完遂するのは、かなり狭き門と言えるでしょう。ただし、このような制約についてユーザーインターフェース上には説明がありません。
実際に動いたのは、目立たない「Paste」だった
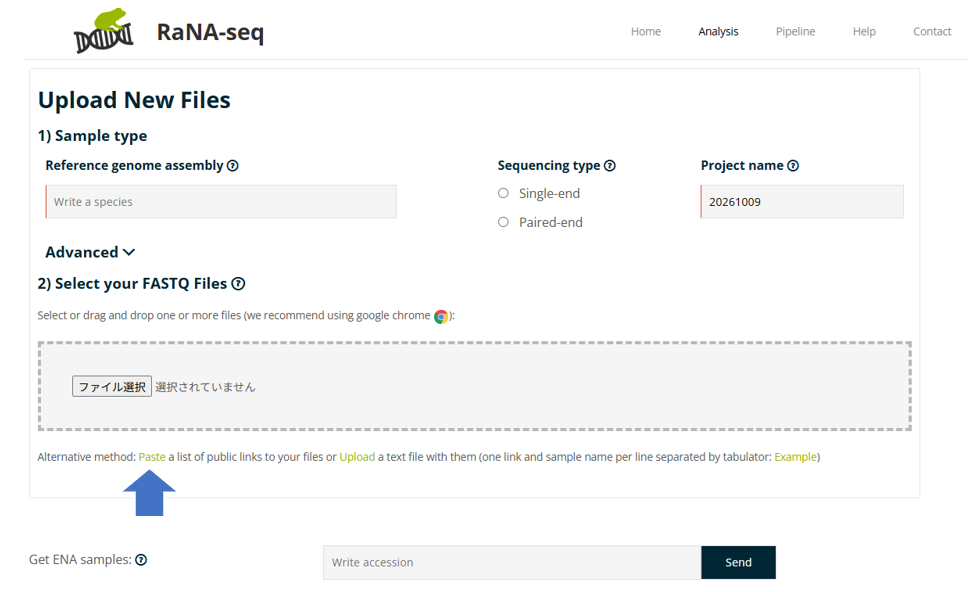
最終的に正常に動作したのは、FASTQファイルのURLを直接指定する方法でした。現在のRaNA-Seqには、Upload New Files画面の下部に Alternative method という説明があり、その中に小さく Paste というリンクがあります。ここにENA上のFASTQ.gzの直接URLを入力すると、RaNA-Seq側でファイルを取得し、正常にquantificationまで進みました。
特筆すべきなのは、この方法でのファイルインポートは非常に高速だということです。条件さえ整えば、FASTQファイルをGene Countsに変換するツールとしては非常にお勧めできます 。
QC reportには図が揃っている。しかし、その先へ進みにくい
Quality Control reportには、発現値のBox Plot、発現遺伝子数、サンプル間類似度のHeatmap、PCAが出力されます。QCでよく使われる図は一通り揃っています。しかし、何を確認すべきなのか、どのような状態なら注意が必要なのか、気になる構造を見つけたら次に何を調べればよいのかという説明はほとんどありません。もちろん、User Manualにはある程度説明があり、解析経験のある人であればそれなりの情報を読み取れるのですが、RaNA-Seqがターゲットとしている「コーディングできなくても簡単に解析ができる」ことを期待するユーザーにそれを期待するのは難しいでしょう。その結果、QCが結果を検証するための工程ではなく、解析を行ったことを示す図を得るだけの工程になってしまう危険があります。
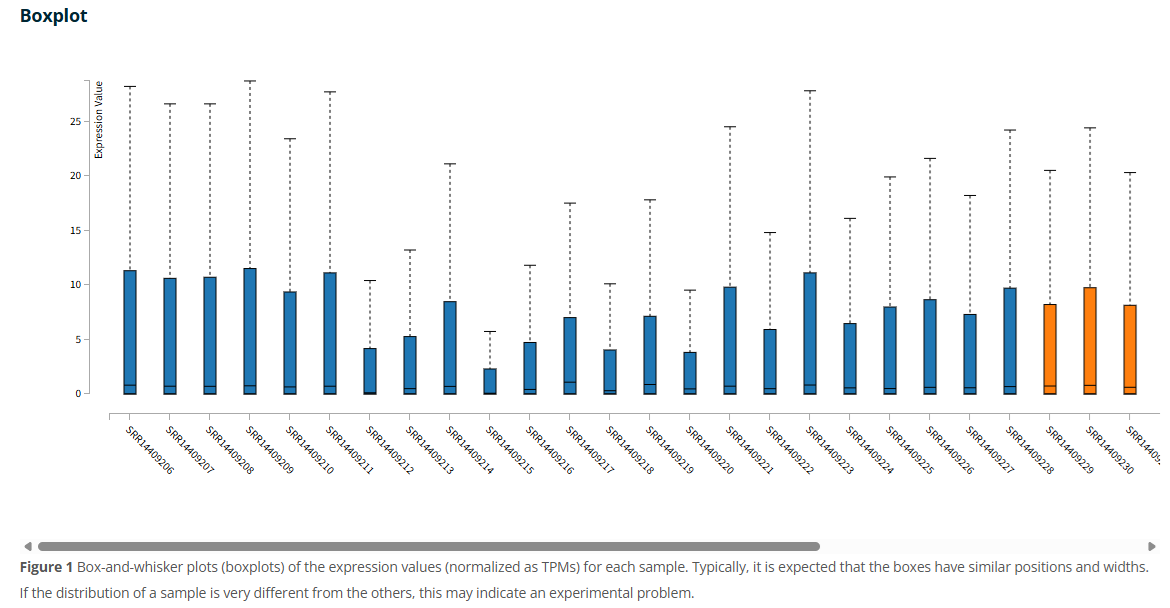
expression values (normalized as TPMs) とありますが、表示されている値の範囲や分布を見ると、TPMそのものを表示しているとは考えにくいです。Gene Countsを対数変換した値である可能性も考えられますが、具体的にどのような値が表示されているのかは確認できませんでした。
今回のPCAでは、PC1だけで94.47%の分散が説明され、いくつかのサンプルが他のサンプルから大きく離れています。そしてその離れたサンプルが、たった1つの例外を除けばmultiple sclerosis (MS)グループに偏っているのです。このような図を実験成功を期待する目で見れば、目論見通り発現プロファイルの違いを捉えることができていると考えてしまうのもありうるでしょう。
ただし、左側にはほぼ同数のMSサンプルとHealthy Controlサンプルの塊があります。これを見ると、経験豊富な解析者であれば「PC1は何に由来しているのだろう」と慎重に考えるでしょう。そして上述のとおり、このデータには本来の解析目的とは異なる要因によって生じたと強く疑われる発現変動が含まれています。問題は、そうした疑問が浮かんでも、それを調べるための手段が提供されていないことです。この構造が実験条件、サンプル属性、発現分布、ライブラリ品質、あるいはtechnical factorと関連しているのかを追跡するには、別の解析環境へ移る必要があります。
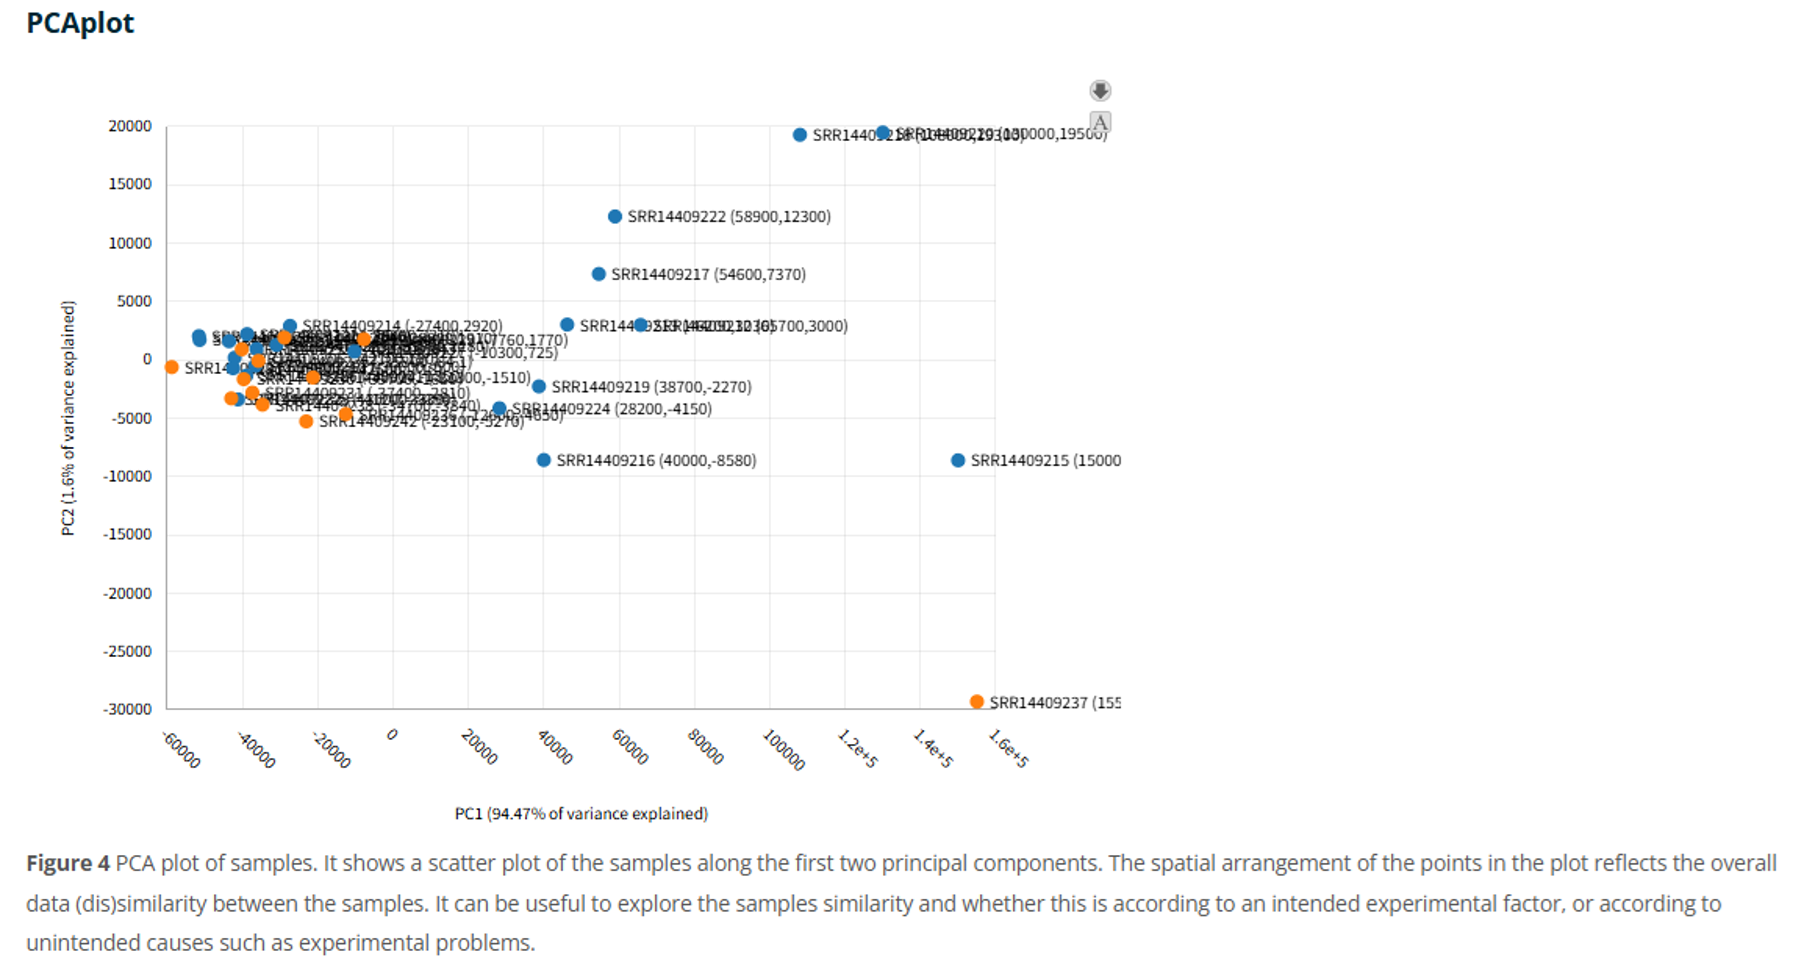
さらに、気になるサンプルが何なのかを調べるには、SRR番号からGSM番号へ戻り、そこからサンプル情報を確認する必要があります。PDFレポートではさらに、1ページ目で各サンプルに1〜36という連番が新たに付けられ、その番号が以降のHeatmapやPCAで使われるため、照合にもう一段階の作業が加わります。
つまり、RaNA-Seqは「データの中に大きな構造がある」ことまでは見せてくれます。しかし、その構造を信頼してよいのか、それとも疑うべきなのかを判断するための情報は十分ではありません。 今回それを疑うことができるのは、別の解析でこのデータの歪みをすでに知っているからです。
これはGalaxyの検証でも問題になりました。「何かおかしいかもしれないことは見える。しかし、その理由を追いにくい。」 という点は共通しています。ただしGalaxyでは、各工程の出力へ戻ったり、別の可視化や解析を追加したりすることができます。RaNA-Seqでは一連の処理がより強く自動化されているため、気になる構造を見つけた後に、その理由を掘り下げるための自由度はさらに低くなります。これは自動化ツールの性質上、ある程度予想されたことではあります。
しかし、このような予想とは別の難しさがあることも見えてきました。
DEレポートを見ても、どのような処理により出た結果なのかが分からない
今回得られたVolcano plotは、一般によく見るVolcano plotとは少し異なる形をしています。このような場合、解析者はなぜこのような形になったんだろうという疑問を持ち、その理由を調べるだろうと思います。しかし、RaNA-Seqではそのような探索を行える機能を提供していません。
さらにMA plotを見ると、低発現領域のlog2 fold changeが強く0付近に集まっています。何らかの低発現値に対する処理、あるいは変動幅を縮小する処理が行われていることは明白であるように見えます。しかし、レポートやUser Manualを確認しても、この特徴的な分布を生じさせている具体的な処理を特定できる説明は見つかりません。User ManualにはMA plotの一般的な意味は書かれていますが、今回の結果がなぜこの形になるのかを説明する処理内容までは示されていません。
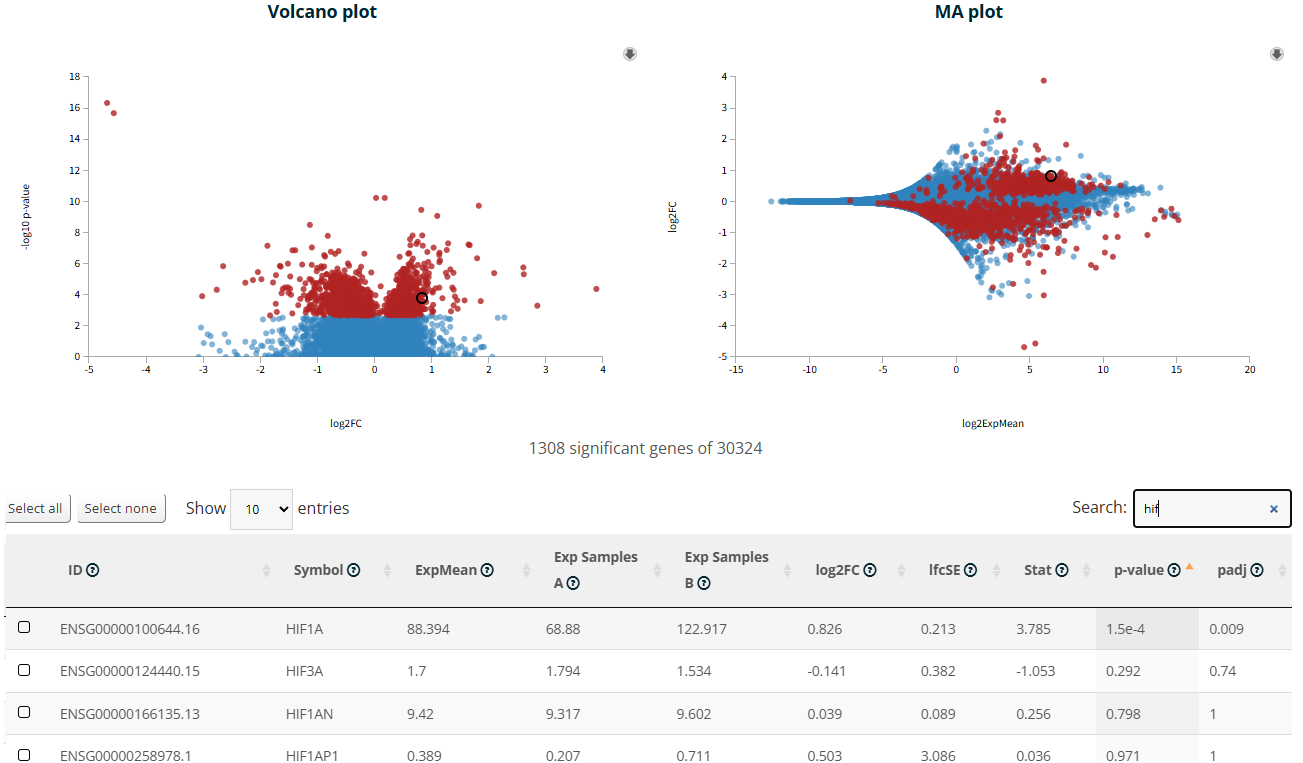
もしこの結果を論文に用いるとして、解析方法や結果の特徴について説明を求められても、どのような処理によってこの結果が得られたのかについて、レポートにもUser Manualにも十分な説明がないため、解析者自身が根拠をもって答えることができません。
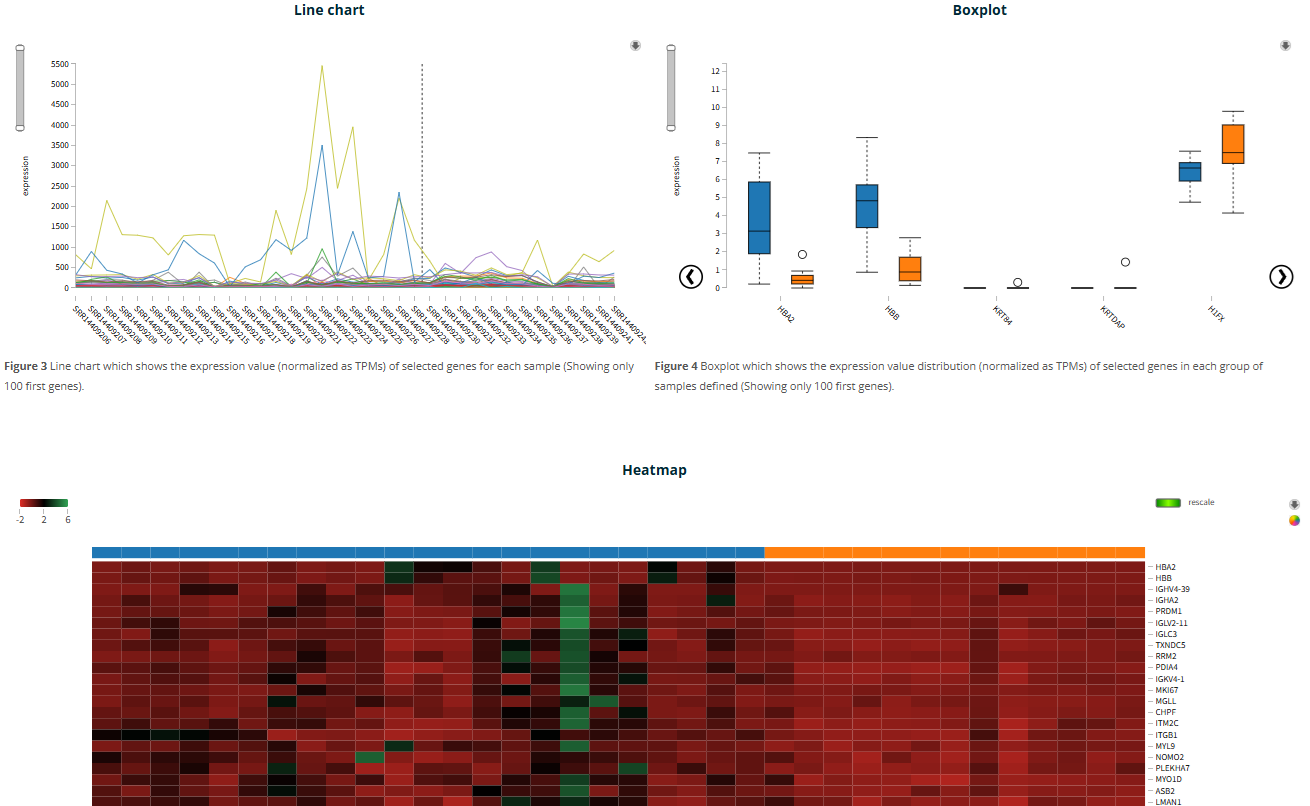
Web版にはPDFにはないline graph、Box Plot、Heatmapなどの可視化もあります。User Manualでは、Line chart、Boxplot、Heatmapはいずれも expression value(s) (normalized as TPMs) を表示すると説明されています。
しかし、Figure 3とFigure 4の縦軸にはどちらもexpressionというラベルが付いているにもかかわらず、スケールはまったく異なります。さらに、Figure 3や4では負数は見られませんが、Figure 5のHeatmapには負数があります。TPMそのものが負になることはありませんので、少なくともHeatmapでは何らかの追加変換が行われているはずです。ここでもやはり、User Manualを読めば「何を表示しようとしている図なのか」は分かりますが、各図で実際にどのような変換を行った値を表示しているのかまでは特定できません。
Materials and Methodsには「RaNA-Seqを使った」と書くしかない
論文を書く場合、不明な処理について「RaNA-Seqを使用した」と記載することで、RaNA-Seq側へ説明を委ねることはできます。しかし、それは同時に、解析者自身が何をしたのかを十分に説明できない部分が残るということでもあります。
Functional EnrichmentはDEGの統計的な選択に強く依存する
RaNA-Seqでは、DE解析で設定したp-value cutoffを満たした遺伝子がDEGとして抽出され、その遺伝子群がFunctional Enrichmentに使われます。今回の設定ではp-value cutoffは0.05でしたが、DEGの抽出条件としてFold Change cutoffを組み合わせる設定は見当たりません。
つまり、Functional Enrichmentへ渡される遺伝子群は、DE解析の統計検定の結果に強く依存します。p-value cutoffを0.05にするのか、より厳しくするのかによって、入力される遺伝子数も、その後に得られるGO・Pathwayの結果も変わります。それだけ重要な設定であるにもかかわらず、今回のデータに対してどのp-value cutoffが適切なのかを判断するための情報は限られています。できるのは、設定を変えながら再解析を行い、抽出されたDEGの数の違いと、Volcano PlotやMA Plotで違いを比較することです。しかしこれらは平均を見ているに過ぎません。個別のサンプルを見て、外れ値やバッチエフェクトが結果を歪めていないかどうかを確かめることはできません。
統計的に有意かどうかは重要な情報ですが、それ以前にその検定を用いることが妥当だったかどうかを確かめる手段が提供されていません。検定方法や一部の設定を変更する自由度はありますが、問題は、どのような設定がこのデータにとって適切かを検討する手段が乏しいことです。
GenesAnot列は評価できる
一方、Functional EnrichmentのExcel結果に GenesAnot 列が含まれている点は明確に評価できます。これにより、各GO termやPathwayに具体的にどの遺伝子が含まれているのかを確認できます。同じ遺伝子が多数の有意termに繰り返し含まれていれば、「多数の独立した生物学的現象が変化しているのではなく、限られた遺伝子群が多くの関連termを同時に有意にしているのではないか」を検証することができます。「GO解析・Pathway解析で原因はわかるのか?」でも述べているとおり、GOにしろPathwayにしろ背景として使っている知識そのものに偏りがあるので、このような検証は誤った解釈を導き出さないためにとても重要です。
さらに、その遺伝子について個々のサンプルでの発現パターンまで戻ることで、仮説と観測値の照合をすることもできます。ただし、その確認はRaNA-Seq内では行えませんので、別の解析・可視化環境が必要になります。それでも、結果を構成している遺伝子まで追える情報が出力されていること自体はとても高く評価できます。
具体的にどのような情報が含まれているのか確認したい方は、こちらをダウンロードし、GOSEQ_PathResults.xlsx または GOSEQ_GOResults.xlsx の GenesAnot 列をご覧ください。
Web版の可視化は洗練されている
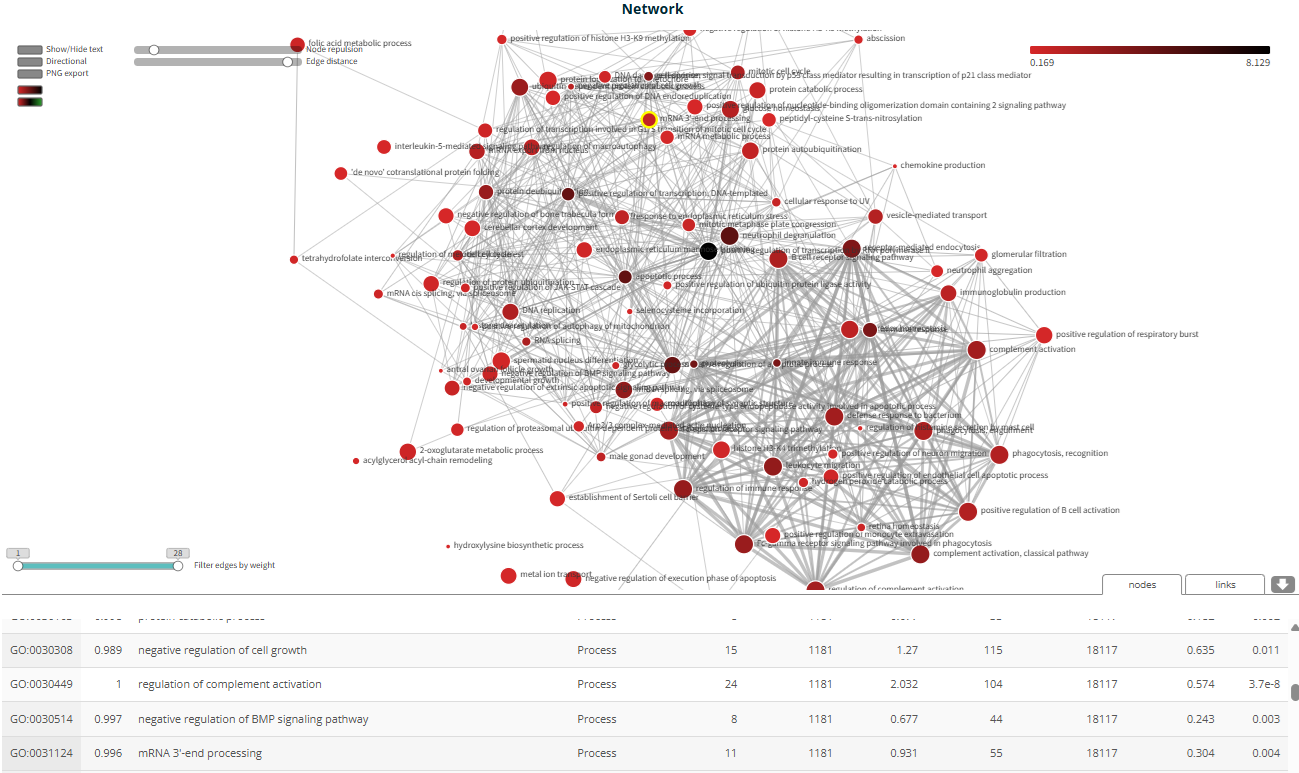
RaNA-SeqのWeb reportには、PDFには含まれない多数の可視化があります。Bar plot、GO termのネットワーク、functional category間で共有される遺伝子数のSymmetric Heatmapなどで、ネットワークグラフではnode repulsionやedge distanceをスライダーで変更でき、ノードは非常に滑らかに再配置されます。インタラクティブな可視化としてはかなり魅力的で、見た目の完成度は高いです。
ただし、複雑で専門的な印象を与えるネットワーク図も、その構造自体が今回の生物学的な問いへの答えを示しているわけではありません。ノードとエッジが密集して読みにくくなったネットワーク図は英語ではしばしば “hairball” と呼ばれますが、今回もまさに立派な「毛玉」が得られました。これらの図が示しているのは、GO termやPathwayの間で遺伝子がどの程度共有されているかという構造です。この情報自体に意味がないわけではありませんが、今回の研究上の問いに対して、ここから何を判断すればよいのか。この図を生物学的に読み解くのは至難です。
その点では、見た目の派手なネットワーク図より、上述のExcel結果に含まれる GenesAnot 列の方が、実際の検証には役立ちます。見栄えのよい図があることと、検証の役に立つことは、まったくの別物です。
GSEAの結果は出る。しかし、何を意味しているのか理解するのは難しい
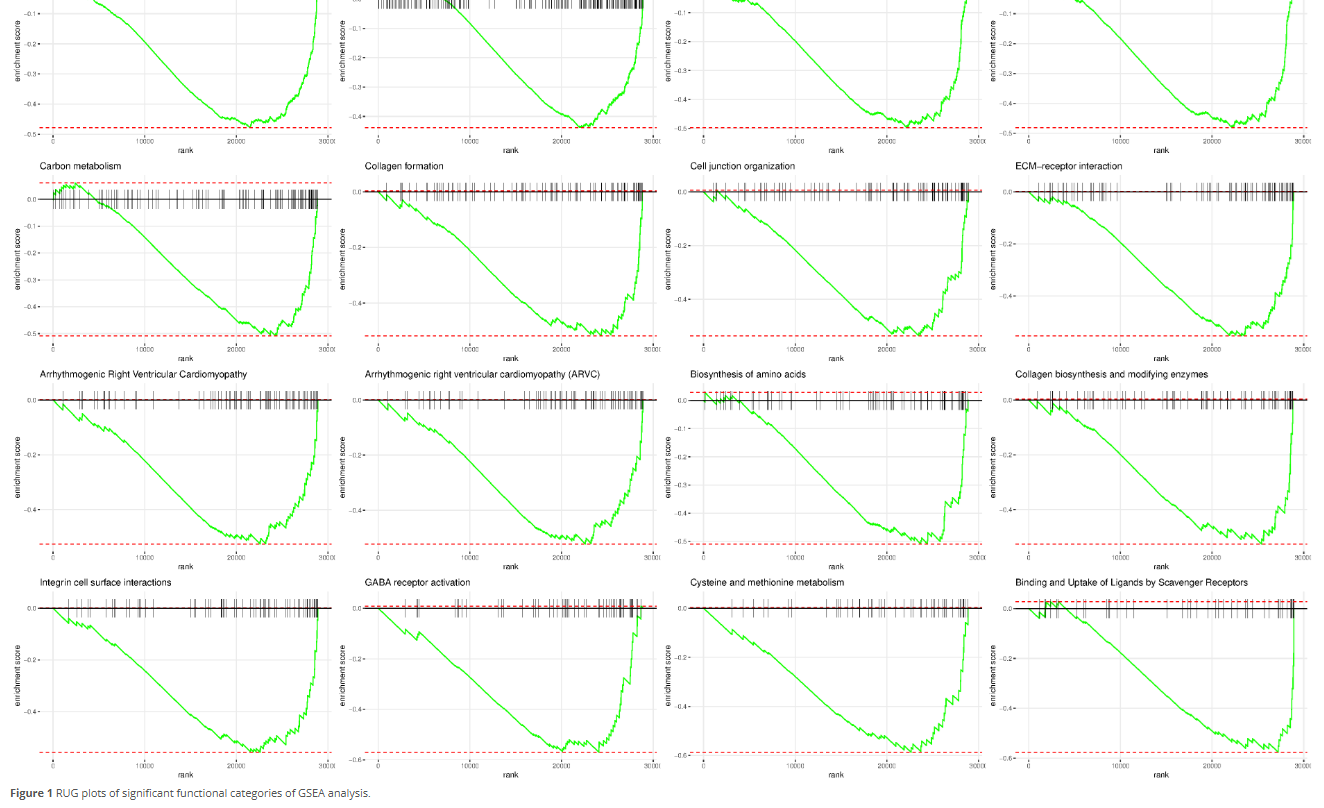
RaNA-Seqではfgseaを使ったGSEAも自動的に実行され、多数のRUG plotが出力されます。User Manualには、GSEAの一般的な結果項目については説明がありますが、GSEAに詳しくない利用者にとって、この図が今回の実験で何を意味しているのかを理解するのは簡単ではありません。
たとえば、今回の結果を見て、gene setに含まれる遺伝子がランキングの一方に明瞭に偏っているようには見えないものでも、非常に小さなP値が得られていることに疑問を持つかもしれません。GSEAは単純に「上昇側に何個、下降側に何個あるか」を見る方法ではないため、図を眺めただけでは結果の意味を直感的に理解しにくいことがあります。そのため、P値やenrichment scoreの高い結果から順に見れば、それだけで生物学的な意味を理解できるというものでもありません。したがって、GSEAがピックアップしたGeneSetについても、それぞれこの研究にとって意味があるものかどうかは解析者が一つ一つ判断する必要があります。しかし、こうした専門的に見える図が多数出力されると、その意味を十分に検証する前に、「論文に使えそうな図が得られた」という満足感が先に立ってしまう危険もあるように感じます。
一方、ここでも説明が足りない問題が確認されました。User Manualを確認しても、今回の解析で具体的に何をranking metricとして使用したのか、そのランキングの左右がSamples AとSamples Bのどちらに対応するのかは明確ではありません。leading-edge genesという概念は説明されていますが、そのgene setが今回の比較でどちらの条件と関連するのかを判断するためには、今回の解析におけるrankの定義が必要です。したがって、今回の解析においてこれらの図が具体的に何を意味するのかを確認するための情報は十分ではありません。
RaNA-Seqは、ある時代を象徴するツールなのかもしれない
ここまでを見ると、RaNA-Seqにかなり厳しい評価をしているように思えるかもしれません。しかし、RaNA-Seqが登場した時代を考える必要があります。つい数年前まで、RNA-Seq解析で大きな価値を持っていたのは、解析ツールを動かせることでした。コマンドラインを使える。Rを書ける。Salmonを実行できる。DESeq2を実行できる。GO解析ができる。それらを一通り動かすだけでも、かなりの知識と経験が必要でした。その時代に、FASTQを入れれば、コーディングなしで、非常に速く、美しい結果まで出してくれるRaNA-Seqが登場しました。これは歓迎されても不思議ではありません。難しい操作を隠し、RNA-Seq解析を多くの研究者に開くという意味で、当時としては非常に合理的な設計だったと思います。
しかし、AIによって前提が変わった
現在は状況が変わっています。RやPythonを書けなくても、AIにコード作成を手伝ってもらえます。DESeq2の実行方法を知らなくても、AIに実行方法を説明してもらえます。さらに重要なのは、「なぜこのフィルターを使うのか」「なぜこの正規化をするのか」「このMA plotはなぜこの形なのか」「この実験ではどのcontrastを設定するべきか」「Methodsには何を書けばよいのか」と質問することもできます。もちろん、AIの回答が常に正しいわけではありませんが、解析ツールをただ動かせばよかった時代は、確実に終わりつつあります。
すると、自動解析ツールを見るときの評価軸も変わります。以前は「どこまで自動で実行してくれるか」が重要でしたが、現在はむしろ、自動で行われた処理をどこまで人間が理解できるか、その手順と結果の妥当性を検証できるか、必要なら条件を変更して再解析し、結果を比較できるかの方が重要になっています。
かつては長所だった「操作が簡単であること」、その代償としての硬直した自動化は、以前ほど魅力的ではなくなっていくでしょう。
AIによって、解析者は本来の役割に戻れる
これは、解析者の仕事がAIに奪われるという話ではありません。むしろ逆です。
AIによってツールを動かす負担が小さくなれば、解析者はその時間を、何を調べるべきかを考えること、データの状態を見ること、解析方法が適切かを判断すること、得られた結果を疑うこと、元のデータへ戻って確認すること、条件を変えて再解析し、異なる結果を比較することに使えるようになります。
これらは、本来、解析者が担うべき仕事だったはずです。
AI以前の自動解析ツールは、難しい操作を隠すことで解析を簡単にしました。しかし、操作そのものをAIに手伝ってもらえるようになった現在では、処理内容まで隠す必要はありません。むしろ、何が行われたのかを確認でき、なぜその結果になったのかを考え、疑問があれば元のデータまで戻って検証できることの方が重要になります。
AIによって、解析者はようやく「ツールを動かす人」から離れ、データを見て、考え、疑い、判断するという本来の役割に戻れるのかもしれません。
結果を出すことではなく、その結果を理解し、検証すること。それが解析者の仕事です。
Subio Platformは、AI・R・Pythonで得られた結果を、見て確かめる場所です。解析結果を可視化し、元のデータと照らし合わせながら、その結果が本当に妥当なのかを確認する。そして、結果を共有して議論につなげる。私たちは、AI時代だからこそ、このような解析環境が重要になると考えています。
自分のデータについて解析方法や結果の解釈を相談したい方には、RNA-Seqデータ解析サービスも提供しています。