この記事では、Windows版Subio Platformで RNA-SeqのFASTQファイルを処理するための パイプラインの設定方法を説明します。 Subio Platformでは、以下のツールを利用してFASTQファイルから遺伝子発現データを取得できます。 macOS版の設定方法はこちらをご覧ください。
| ツール | 役割 | 動作確認済みバージョン |
|---|---|---|
| fastp | アダプター配列の除去、低品質リードのフィルタリング | 1.4.0 |
| Kallisto | Transcriptomeを参照した高速な発現量推定 | 0.52.0 |
| HISAT2 | リファレンスゲノムへのリードのマッピング | 2.2.1 |
| StringTie | HISAT2のマッピング結果を利用したTranscript発現量の推定 | 3.0.3 |
上記はSubio Platformで動作確認したバージョンです。他のバージョンでも動作する場合があります。
この記事では、まずKallistoを使用するパイプラインを設定し、その後、HISAT2–StringTieを使用する場合の設定方法を説明します。HISAT2–StringTieを使用しない場合は、その設定を省略できます。
なお、FASTQファイルの処理中にエラーが発生した場合は、FASTQファイルが保存されているフォルダー内に生成される一時フォルダーを確認してください。その中にあるrun.logには、パイプラインの実行状況やエラーに関する情報が記録されています。run.log.gzとしてgzip圧縮されている場合は、解凍してから内容を確認してください。run.logをChatGPTなどのAIに読み込ませて、エラーの原因や対処方法を相談すると、問題解決の手がかりが得られる場合があります。
1. Windows Subsystem for Linux(WSL)の設定
Windows版Subio Platformでは、Linux用にビルドされたfastp、Kallisto、HISAT2、StringTieを使用します。そのため、Windows上でLinuxのプログラムを実行するためのWindows Subsystem for Linux(WSL)と、LinuxディストリビューションのUbuntuをインストールする必要があります。
WSLがインストールされていない場合は、Microsoftの公式案内に従ってセットアップしてください。すでにWSLとUbuntuを使用できる場合は、この手順を省略できます。
Ubuntuを初めて起動するときには、Linux用のユーザー名とパスワードを設定します。Linuxのデスクトップ環境をインストールする必要はありません。
2. fastpのダウンロードと設定
fastpは、公式GitHubで配布されているLinux用の実行ファイルを使用します。READMEの「or download the latest prebuilt binary for Linux users」に記載されている方法でダウンロードできます。
Ubuntuのターミナルで次のコマンドを実行すると、最新のビルド済み実行ファイルをダウンロードできます。
wget http://opengene.org/fastp/fastp
chmod a+x ./fastp
特定のバージョンを使用したい場合は、バージョンを指定してダウンロードすることもできます。例えば、fastp 1.4.0の場合は次のコマンドを実行します。
wget http://opengene.org/fastp/fastp.1.4.0
mv fastp.1.4.0 fastp
chmod a+x ./fastp
ダウンロードした実行ファイルは、Windowsのエクスプローラーから選択できます。 Subio Platformのパイプライン設定画面では、 Windows上のファイルパスを指定してください。 WSLのパスを入力する必要はありません。
3. Kallistoのダウンロードと設定
Kallistoは、公式GitHubからLinux用の実行ファイルをダウンロードします。
- Kallistoの公式リリースページを開きます。
- kallisto_linux-v0.52.0.tar.gzをダウンロードします。
- ダウンロードしたファイルを展開します。
- Subio Platformのパイプライン設定画面で、展開したKallistoの実行ファイルを指定します。
4. Kallisto Indexの設定
KallistoでFASTQファイルを処理するには、解析対象の生物種に対応したTranscriptomeのIndexファイルが必要です。Subio Platformのパイプライン設定画面で「Download reference data...」ボタンをクリックすると、生物種の選択画面が表示されます。生物種を選択すると、必要な参照データが自動的にダウンロードされ、設定されます。すでに参照データをダウンロードしている場合は、該当するファイルのパスを直接指定することもできます。
5. Kallistoパイプラインの動作確認
FASTQファイルの処理には時間がかかるため、最初は処理するリード数を制限して、パイプラインが正常に動作することを確認します。
- Subio Platformのパイプライン設定画面を開きます。
- fastpの設定で、プリセット「Process 10000 reads」を選択し、「Load」ボタンをクリックします。
- 1~2サンプル分のFASTQファイルをインポートし、処理が最後まで正常に完了することを確認します。
- 動作確認が終わったら、テスト用にインポートしたサンプルを削除します。
- fastpの設定で「Default」を選択し、「Load」ボタンをクリックして通常の処理設定に戻します。
通常の解析を始める前に、必ず「Default」に戻してください。「Process 10000 reads」のままでは、FASTQファイルの一部のリードしか処理されません。
6. HISAT2とStringTieのダウンロードと設定
ここからは、HISAT2–StringTieを使用するパイプラインの設定方法を説明します。Kallistoだけを使用する場合、この後の設定は不要です。すでにダウンロードしたfastpは、そのまま使用できます。
HISAT2のダウンロード
- HISAT2の公式ダウンロードページを開きます。
- HISAT2 2.2.1の「Linux_x86_64」をダウンロードします。
- ダウンロードしたファイルを展開します。
- Subio Platformのパイプライン設定画面で、展開したHISAT2の実行ファイルを指定します。
StringTieのダウンロード
- StringTieの公式リリースページを開きます。
- stringtie-3.0.3.Linux_x86_64.tar.gzをダウンロードします。
- ダウンロードしたファイルを展開します。
- Subio Platformのパイプライン設定画面で、展開したStringTieの実行ファイルを指定します。
ダウンロードしたLinux用実行ファイルに実行権限がない場合は、Ubuntuのターミナルからchmod a+xで実行権限を付与してください。
7. HISAT2 IndexとGTFファイルの設定
HISAT2–StringTieパイプラインでは、リファレンスゲノムのIndexと、遺伝子アノテーションを記載したGTFファイルが必要です。
- 解析対象の生物種に対応するHISAT2 Indexをダウンロードします。
- Indexに使用されているリファレンスゲノムと同じバージョンに対応するGTFファイルを用意します。
- Subio Platformのパイプライン設定画面で、HISAT2 IndexとGTFファイルのパスを指定します。
HISAT2 IndexとGTFファイルは、同じリファレンスゲノムに対応するものを使用してください。異なるゲノムバージョンを組み合わせると、発現量の推定結果に影響する可能性があります。
8. HISAT2–StringTieパイプラインの動作確認
HISAT2–StringTieパイプラインも、最初は処理するリード数を制限して動作確認を行います。
- Subio Platformのパイプライン設定画面で、fastpのプリセット「Process 10000 reads」を選択し、「Load」ボタンをクリックします。
- HISAT2–StringTieパイプラインを使用して、1~2サンプル分のFASTQファイルをインポートします。
- 処理が最後まで正常に完了することを確認します。
- テスト用にインポートしたサンプルを削除します。
- fastpのプリセットを「Default」に戻し、「Load」ボタンをクリックします。
本番の解析では「Default」プリセットを使用してください。
9. 通常のFASTQ処理を開始する
以上で、RNA-Seq FASTQ処理パイプラインの設定は完了です。動作確認用の設定を解除したことを確認してから、解析対象のFASTQファイルをインポートしてください。なお、ここまでの動作確認は、パイプラインが最後まで実行できることを確かめるためのものです。得られた発現データの信頼性については、リードの品質、マッピング結果、サンプル間の発現分布などを確認することが重要です。詳しくは、データの可視化によって解析結果の問題を発見するケーススタディも参考にしてください。
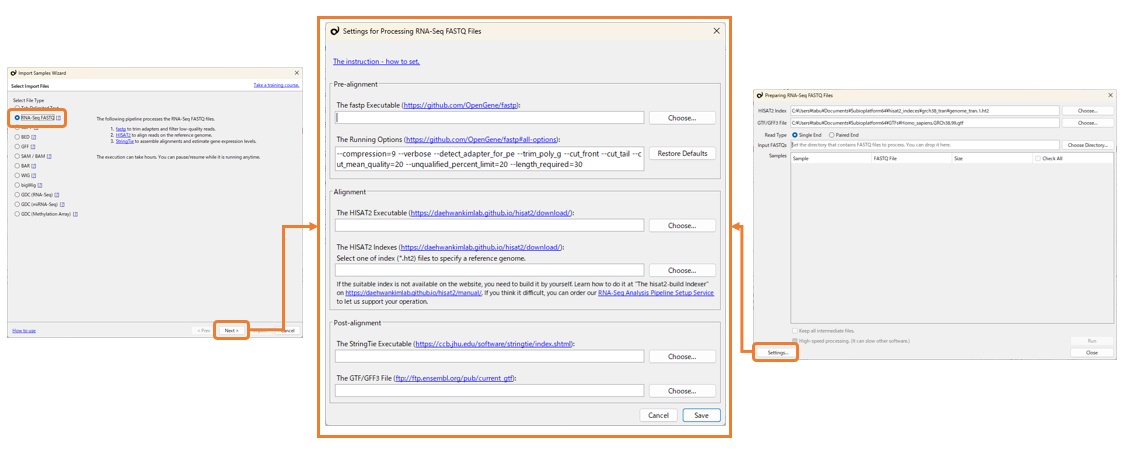
Subio Platformのパイプライン設定画面と実行画面の遷移
以下の図は、Subio Platformのパイプライン設定からFASTQファイルの処理実行までの画面遷移を示しています。KallistoとHISAT2–StringTieのどちらも、基本的な操作の流れは共通しています。