本来の解析目的とは異なる要因によって生じたと強く疑われる発現変動が含まれているデータセットを使って、 Galaxyで解析した場合にデータの歪みに気づけるか、 あるいは RaNA-Seqで解析した場合にデータの歪みに気づけるか を詳しく検証してきました。
その結果、total mapped/assigned readsの数のばらつきやサンプルごとのGene Countsのボックスプロット、そしてPCAをレポートで見るだけでは、何かおかしいかもしれないと気づくことはできても、これらのサンプルを除去すべきかどうかを判断することは難しいこと、そして、そのような判断のためには複数の情報を統合的に見ることのできる環境が必要なことが分かりました。正しいツールをパイプラインで実行するだけでは、解析結果の妥当性・信頼性まで確認したことにはなりません。
今回は、その比較をする中で見つかった、Ensembl Gene IDベースのGene CountsをGene-level解析へ持っていくときの注意点を紹介します。
同じデータなのに、RaNA-Seqでは歪みが見えにくい
GEOで提供されているGene Countsと、GalaxyでHISAT2 + featureCountsを使って計算したGene Countsについて、各遺伝子をCenteringして平均値に対するLog2 Ratioとして表示すると、一部のサンプルでこれまで確認してきた歪みがはっきりと見えます。ところが、RaNA-Seqで得たGene Countsを同じ方法で表示すると、全体のばらつきが非常に大きく、同じ歪み構造が他の変動に埋もれて見えにくくなりました。
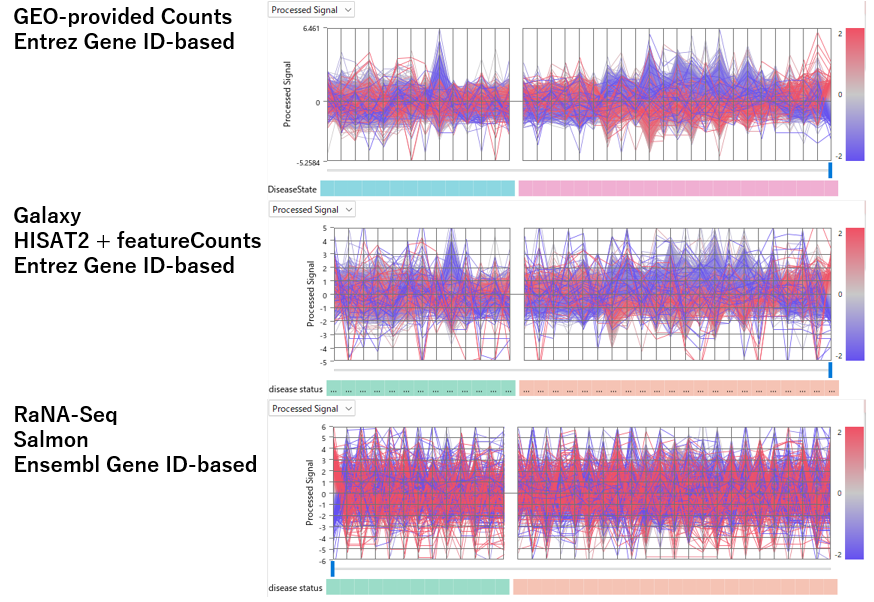
GEOで提供されているGene CountsとGalaxyのGene CountsはEntrez Gene IDベースですが、RaNA-SeqのGene CountsはEnsembl Gene IDベースという違いがあります。そこで、RaNA-Seqの出力をもう少し詳しく確認してみました。
同じGene Symbolに複数のEnsembl Gene IDがある
RaNA-SeqのGene Countsを見ると、同じGene Symbolに複数のEnsembl Gene IDが対応しているケースが多数ありました。例えばRPS9を見ると、同じRPS9というGene Symbolを持つ複数のEnsembl Gene IDが別々の行として存在しています。さらに興味深いのは、それぞれのIDに割り当てられるCountsの割合がサンプル間で一定ではないことです。あるサンプルでは特定のENSG IDに多くCountsが入り、別のサンプルでは別のENSG IDへのCountsが増えています。しかし、これらのCountsをRPS9として合算すると、多くのサンプルで約2万前後の値になります。
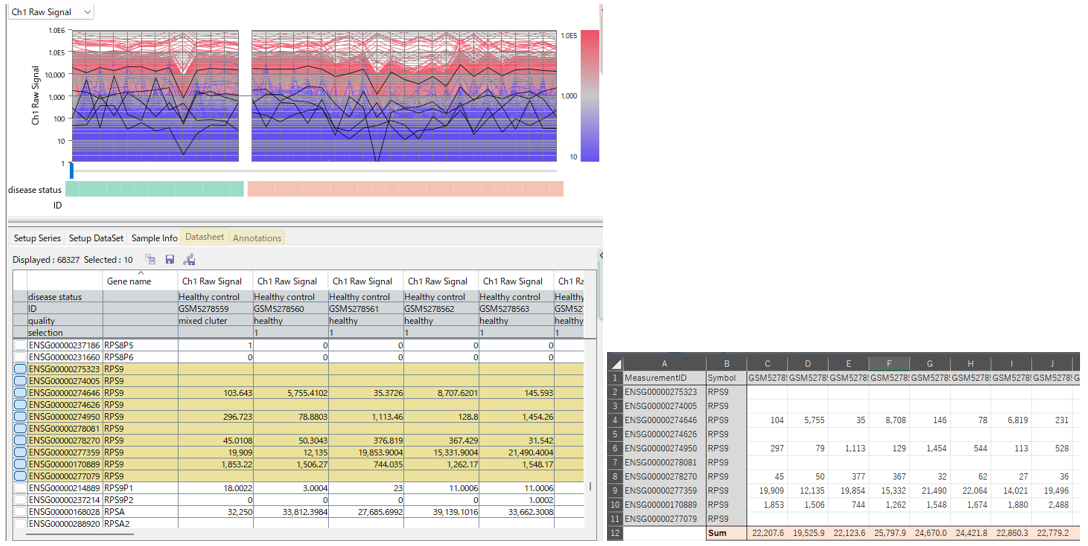
つまり今回のデータでは、RPS9全体の発現量が大きく変動しているというより、RPS9に対応する複数のEnsembl Gene IDの間で、Countsの配分がサンプルごとに変化しているように見えます。このような状態で各Ensembl Gene IDを独立したgeneとして扱えば、gene全体としては比較的安定しているにもかかわらず、個々のIDでは大きなサンプル間変動があるように見えます。
これが、RaNA-SeqのEnsembl Gene IDベースのGene Countsで全体のばらつきが大きく見えた理由の一つではないかと考えました。
Gene Symbol単位で合算してインポートする
そこで、Gene-levelの解析を行うという目的に合わせて、同じGene Symbolに対応するCountsをサンプルごとに合算してみることにしました。
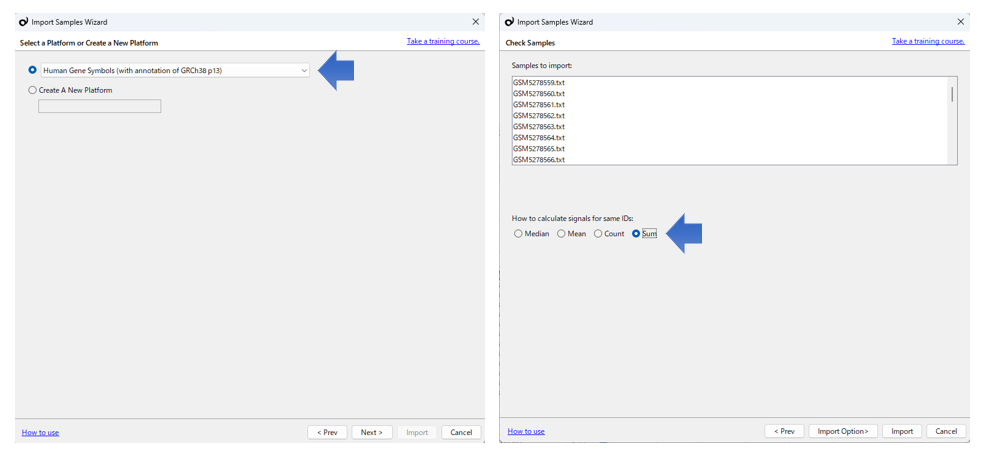
Subio Platformでは、Sample Import WizardでEnsembl Gene IDベースのPlatformではなく、Gene SymbolベースのPlatformを選択します。さらに、同じIDが複数存在する場合の処理を指定するHow to calculate signals for same IDsで、Sumを選択します。これにより、同じGene Symbolを持つ複数行のCountsが各サンプル内で合算され、Gene Symbol単位のGene Countsとしてインポートされます。
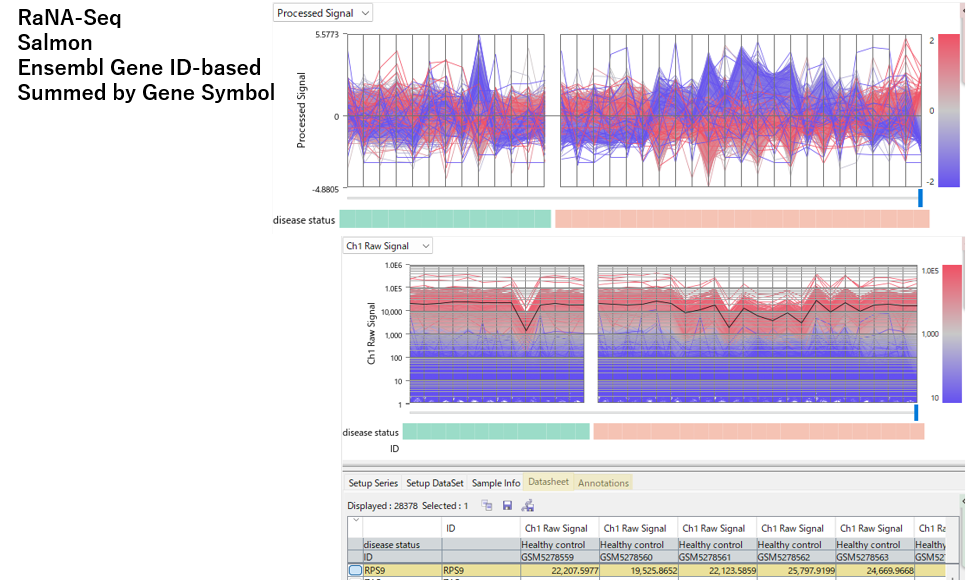
RPS9も複数のENSG IDではなく1つのRPS9として表示され、各サンプルの値は先ほどExcelで計算した合計値と同じになります。そして、この状態でもう一度全体を可視化すると、Ensembl Gene ID単位では他のばらつきに埋もれていたサンプル固有の歪み構造が、はっきり確認できるようになりました。
つまり、RaNA-SeqのGene Countsからこの歪みの構造が失われていたわけではありません。Ensembl Gene ID単位で見ることで、同じGene Symbolに対応する複数ID間のCounts配分の変動が加わり、gene-levelで見たい構造が埋もれていたと考えられます。
ENSG IDベースのCountsは、Gene-level解析の前にGene Symbolで合算する
今回確認した現象はGSE173789における結果であり、すべてのRNA-Seqデータで同じ程度の違いが生じるとは限りません。しかし、ここから言える実務上のルールとしてはシンプルです。
PCA、クラスタリング、DEG解析、ヒートマップなど、Gene-levelの後段解析を行うのであれば、ENSG IDベースで出力されたGene Countsは、同じGene Symbolに対応するCountsを合算してから解析することを推奨します。
Gene Countsという名前が付いているからといって、すべてのCountsテーブルがまったく同じ単位で集計されているわけではないということです。後段解析でgene-levelの発現解析を行うなら、Gene Symbol単位で合算した値を用いることで、解析の妥当性・信頼性を高めることができます。
結果を出すだけならできる。違和感を調べるのは別の問題
今回行った処理自体は、Galaxyでも不可能ではありません。しかし実際に解析作業を進めるうえでの問題は、「できるかどうか」だけではありません。気づけるかどうか、あるいは、気づいたことを複雑な手間をかけずに検証できるかどうかにあります。
今回も最初から「Gene Symbolで合算しよう」と考えていたわけではありません。RaNA-Seqの結果を可視化して、Galaxyでは見えていた構造がなぜ見えないのだろうという違和感から始まりました。そこから個々のgeneを確認し、同じGene Symbolに複数のEnsembl Gene IDがあることに気づき、RPS9のような具体例を調べ、「では合算したらどうなるのか」と試しています。
繰り返しになりますが、違いはその疑問をどれだけ見つけやすく、どれだけ簡単に確かめられるかです。
Galaxyには、RNA-Seq解析に利用できる多くのツールが用意されています。RやPythonを使えば、さらに自由に解析パイプラインを構築できます。一方、Subio Platformは、多数の解析アルゴリズムを備えることを目的としたソフトウェアではありません。得られた結果を可視化し、違和感を見つけ、その原因を検証しやすくすることを重視しています。
そのため、これらは競合するものではなく、補完的に使うことができます。Galaxy、R、Python、あるいはAIを使って解析結果を作り、Subio Platformでその結果を見て確かめる。必要であれば再び解析方法を変更し、その結果をもう一度比較する。この往復が、解析結果を理解し、妥当性・信頼性の高い解析を行ううえで重要です。
Visualize and validate your results
RNA-Seq解析では、結果を自動的に出すことそのものは、以前よりはるかに簡単になっています。AIを使えば、RやPythonのコードを作ることも難しくなくなりました。しかし、解析結果が出たことと、その結果を理解したことは同じではありません。
どのツールを使って結果を得たとしても、それを可視化し、別の角度から確認し、必要なら解析方法を変えてもう一度確かめる。そして、その結果を他の研究者と共有し、議論する。Subio Platform は、そのためのツールとして設計されています。